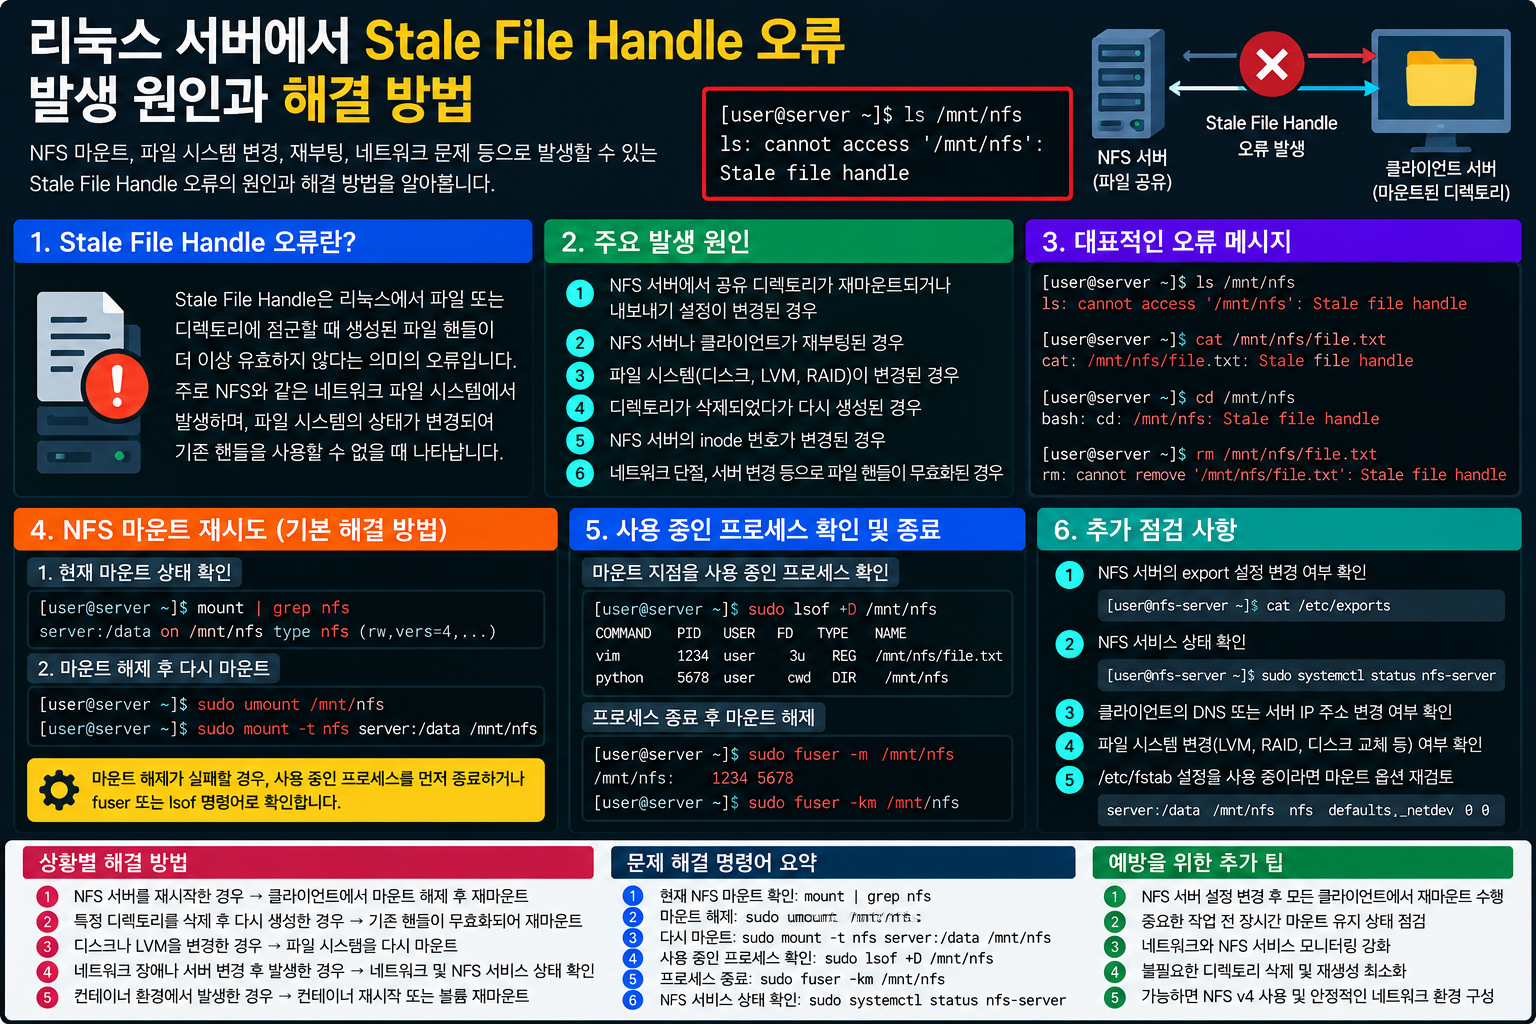
[태그:] 리눅스 서버 오류

  • 리눅스 서버에서 Device or Resource Busy 오류가 발생하는 원인과 해결 방법

    리눅스 서버에서 Device or Resource Busy 오류가 발생하는 원인과 해결 방법

    리눅스 서버에서 디렉터리를 삭제하거나 디스크를 마운트 해제하려고 할 때 Device or Resource Busy 오류가 발생해 작업이 중단된 경험이 있으신가요? 특히 백업 작업이 끝난 뒤 외장 디스크를 분리하거나, Docker 컨테이너를 정리하고 디렉터리를 삭제하는 과정에서 이런 오류가 나타날 수 있습니다.

    분명 사용 중인 프로그램이 없어 보이는데도 umount나 rm 명령이 실패하면 파일 권한이나 디스크 자체의 문제부터 의심하기 쉽습니다. 하지만 실제로는 다른 프로세스가 해당 경로를 열어두었거나, 현재 작업 디렉터리로 사용하거나, 하위 마운트가 남아 있는 경우가 많습니다.

    이럴 때 무작정 kill -9으로 프로세스를 종료하거나 강제 마운트 해제를 시도하면 운영 중인 서비스와 데이터에 영향을 줄 수 있습니다. 따라서 먼저 어떤 자원이 사용 중인지 확인하고, 점유 원인에 맞는 방법으로 안전하게 해제해야 합니다.

    이번 글에서는 Device or Resource Busy 오류가 발생하는 대표적인 상황을 구분하고, lsof, fuser, findmnt를 이용한 점검부터 프로세스 종료, 마운트 해제, Docker 환경 점검까지 실제 해결 순서대로 살펴봅니다.

    Device or Resource Busy 핵심 명령어 한눈에 보기

    오류가 발생한 경로가 /mnt/data라고 가정하면 다음 명령어부터 확인할 수 있습니다.

    점검 목적 명령어
    열린 파일 확인 sudo lsof +D /mnt/data
    마운트 사용 프로세스 sudo fuser -vm /mnt/data
    마운트 상태 확인 findmnt -R /mnt/data
    현재 작업 위치 확인 pwd
    프로세스 상세 정보 ps -fp PID

    lsof +D는 지정한 디렉터리 아래를 재귀적으로 탐색하므로 파일이 많은 경로에서는 실행 시간이 길어질 수 있습니다. 마운트 해제가 목적이라면 fuser -vm과 findmnt를 먼저 확인하는 편이 효율적입니다.
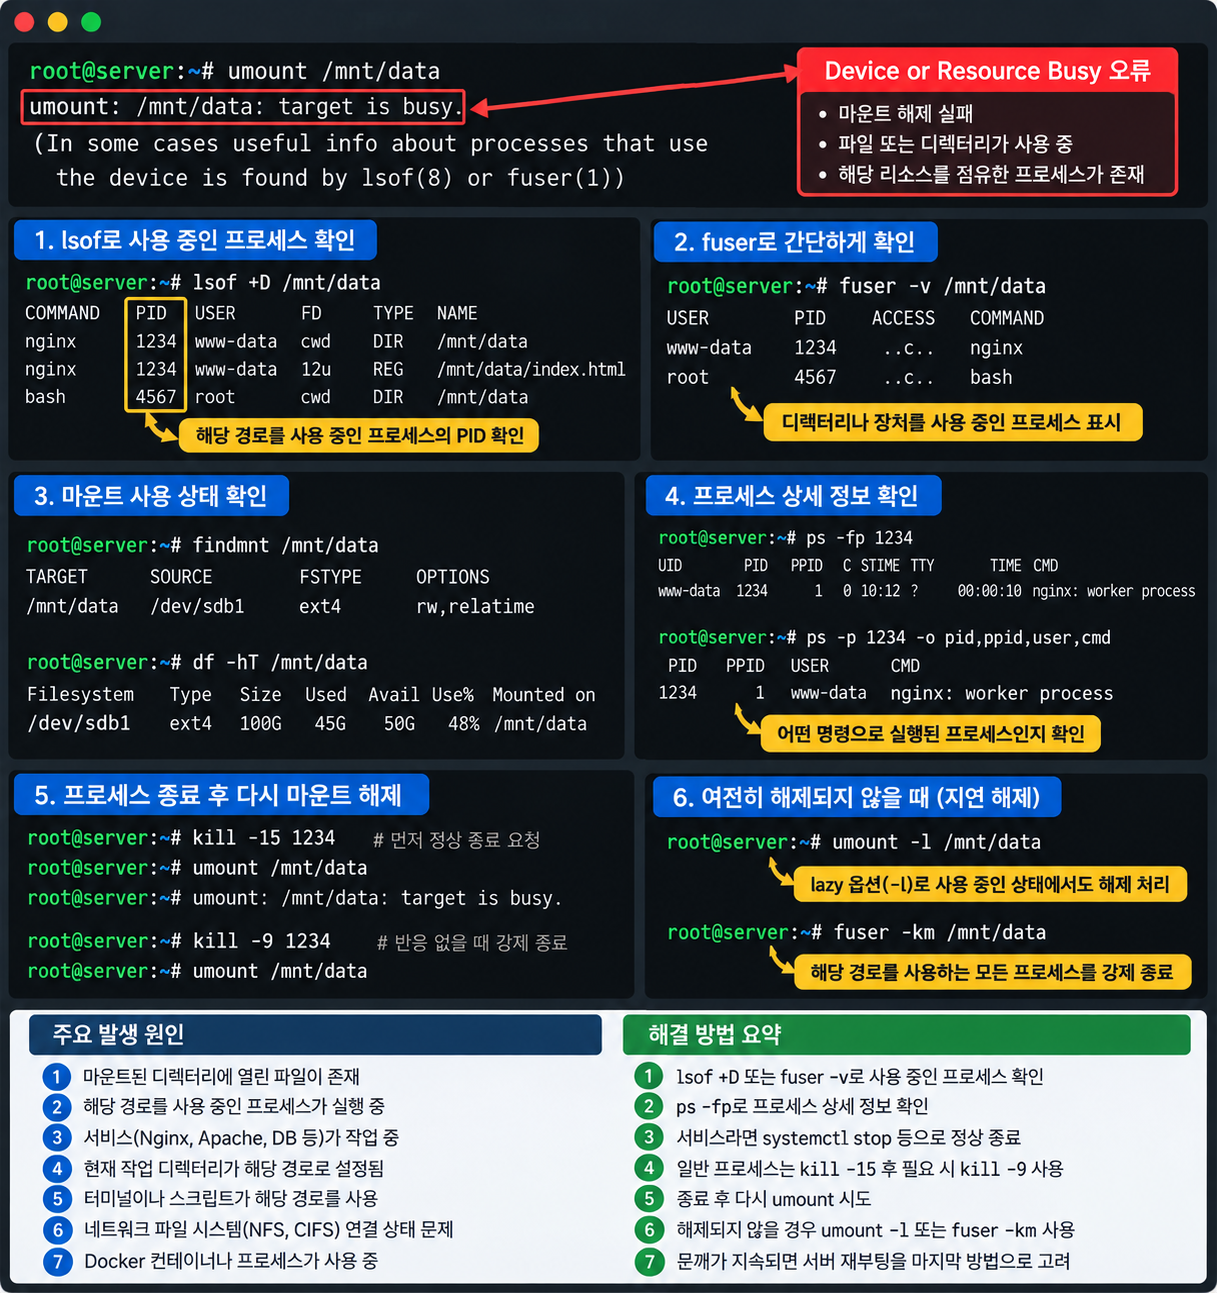
    Device or Resource Busy 오류 발생 후 fuser 명령어로 마운트 지점을 사용 중인 프로세스를 확인하는 예시입니다.

    1. Device or Resource Busy 오류가 발생하는 이유

    Device or Resource Busy는 리눅스에서 주로 EBUSY 오류에 해당합니다. 요청한 작업을 처리하려는 시점에 커널이 해당 자원을 사용 중이라고 판단해 작업을 거부하는 상황입니다.

    다만 같은 오류 메시지라도 실행한 명령어에 따라 원인은 달라집니다.

    • umount 실패: 열린 파일, 작업 디렉터리, 하위 마운트 등이 남아 있는 경우
    • rm 또는 rmdir 실패: 삭제 대상이 마운트 지점이거나 커널이 사용 중인 특수 경로인 경우
    • mv 실패: 마운트 지점이나 사용 중인 특수 자원을 이동하려는 경우
    • Docker 작업 실패: 컨테이너의 볼륨이나 Bind Mount가 남아 있는 경우
    • 네트워크 스토리지: NFS 등의 연결 상태나 마운트 참조가 정리되지 않은 경우

    중요한 점은 일반 파일이 다른 프로세스에서 열려 있다는 이유만으로 항상 rm이 실패하는 것은 아니라는 것입니다. 리눅스에서는 열린 일반 파일도 삭제할 수 있으며, 파일을 사용 중인 프로세스가 종료될 때까지 실제 저장 공간이 유지될 수 있습니다.

    따라서 어떤 명령에서 오류가 발생했는지 먼저 구분해야 불필요한 프로세스 종료나 권한 변경을 피할 수 있습니다.

    2. lsof와 fuser로 자원을 사용하는 프로세스 찾기

    마운트 지점이나 디렉터리를 사용 중인 프로세스를 찾으려면 lsof와 fuser를 사용할 수 있습니다.

    먼저 디렉터리 아래에 열린 파일이 있는지 확인합니다.

    sudo lsof +D /mnt/data

    다음은 출력 예시입니다.

    COMMAND  PID   USER  FD   TYPE  NAME
    bash     2451  root  cwd  DIR   /mnt/data
    python3  3180  app   5r   REG   /mnt/data/report.csv

    여기서 확인해야 할 부분은 COMMAND, PID, FD, NAME입니다.

    • bash / 2451 / cwd: Bash 프로세스가 해당 디렉터리를 현재 작업 위치로 사용
    • python3 / 3180 / 5r: Python 프로세스가 파일을 읽기 모드로 열어둔 상태

    마운트 지점을 기준으로 사용 중인 프로세스를 확인하려면 다음 명령어도 유용합니다.

    sudo fuser -vm /mnt/data

    출력 결과는 환경에 따라 다음과 비슷하게 나타납니다.

                         USER   PID ACCESS COMMAND
    /mnt/data:           root  2451 ..c.. bash
                         app   3180 f.... python3

    ACCESS에 표시되는 c는 현재 작업 디렉터리, f는 열린 파일과 관련된 사용 상태를 의미합니다.

    다만 lsof와 fuser 결과가 비어 있다고 해서 마운트가 완전히 해제 가능한 상태라고 단정할 수는 없습니다. 하위 마운트, 다른 마운트 네임스페이스, 커널 수준의 참조 등도 확인해야 합니다.

    3. 현재 작업 디렉터리와 하위 마운트 확인하기

    터미널에서 마운트 지점 안으로 이동한 상태라면 해당 셸 자체가 마운트 해제를 방해할 수 있습니다.

    예를 들어 다음과 같은 상황입니다.

    cd /mnt/data
    sudo umount /mnt/data

    이때 다음 오류가 발생할 수 있습니다.

    umount: /mnt/data: target is busy.

    먼저 현재 작업 디렉터리를 확인합니다.

    pwd

    현재 위치가 마운트 지점 내부라면 다른 디렉터리로 이동합니다.

    cd /
    sudo umount /mnt/data

    단, 다른 터미널이나 프로세스가 같은 마운트를 사용 중이라면 현재 셸만 이동해도 문제가 해결되지 않을 수 있습니다.

    또한 마운트 지점 아래에 다른 파일시스템이 연결되어 있다면 상위 마운트를 해제하기 전에 하위 마운트를 먼저 확인해야 합니다.

    findmnt -R /mnt/data

    예를 들어 다음과 같이 표시될 수 있습니다.

    TARGET            SOURCE      FSTYPE
    /mnt/data         /dev/sdb1   ext4
    /mnt/data/backup  /dev/sdc1   ext4

    이 경우 /mnt/data/backup에 연결된 파일시스템부터 안전하게 해제한 뒤 상위 마운트를 점검해야 합니다.

    4. 사용 중인 프로세스를 안전하게 종료하는 방법

    fuser나 lsof로 PID를 확인했다면 먼저 해당 프로세스가 무엇인지 검증해야 합니다.

    ps -fp 3180

    서비스로 관리되는 프로세스라면 직접 PID를 종료하기보다 해당 서비스의 상태를 확인하는 것이 우선입니다.

    sudo systemctl status 서비스명

    정지해도 되는 서비스인지 확인했다면 정상적인 서비스 종료를 사용합니다.

    sudo systemctl stop 서비스명

    직접 실행한 프로세스라면 정상 종료 신호인 SIGTERM을 보낼 수 있습니다.

    sudo kill -15 3180

    프로세스가 종료됐는지 확인한 뒤 다시 마운트 해제를 시도합니다.

    ps -p 3180
    sudo fuser -vm /mnt/data
    sudo umount /mnt/data

    SIGTERM으로 종료되지 않는 경우에도 바로 강제 종료하기보다는 작업 상태와 서비스 영향을 확인해야 합니다.

    kill -9는 정상 종료 처리를 거치지 못하게 하므로 데이터 쓰기 작업이 진행 중인 프로세스에는 특히 주의가 필요합니다. 또한 커널의 중단 불가능한 대기 상태인 D 상태의 프로세스는 SIGKILL을 보내도 즉시 종료되지 않을 수 있습니다.

    5. Docker와 NFS 환경에서 오류가 발생하는 경우

    Docker 컨테이너가 호스트 디렉터리를 Bind Mount로 사용하고 있다면 호스트에서 해당 경로를 정리하려 할 때 마운트 관련 충돌이 발생할 수 있습니다.

    먼저 실행 중인 컨테이너를 확인합니다.

    docker ps

    특정 컨테이너의 마운트 설정을 확인하려면 다음과 같이 실행합니다.

    docker inspect 컨테이너명 --format '{{json .Mounts}}'

    해당 경로를 사용 중인 컨테이너가 확인됐다면 실제 운영 서비스에 영향을 주지 않는지 검토한 뒤 컨테이너를 정상적으로 중지하거나 마운트 설정을 수정해야 합니다.

    docker stop 컨테이너명

    NFS 같은 네트워크 파일시스템에서는 서버 연결 문제, 응답 지연, 마운트 참조 등으로 해제가 어려울 수 있습니다.

    findmnt -T /mnt/data
    sudo fuser -vm /mnt/data

    이때 마운트 해제를 무리하게 반복하거나 파일을 사용 중인 프로세스를 일괄 종료하기보다는 네트워크 파일시스템의 연결 상태와 작업 중인 서비스를 함께 확인해야 합니다.

    6. umount -l 또는 강제 해제를 사용해도 될까?

    일반적인 마운트 해제가 실패할 때 umount -l 또는 umount -f를 해결 방법으로 소개하는 경우가 있습니다. 하지만 두 옵션은 의미와 적용 범위가 다릅니다.

    umount -l은 Lazy Unmount로, 파일시스템을 현재 마운트 계층에서 분리하고 남아 있는 참조가 해제되면 정리를 완료하는 방식입니다.

    sudo umount -l /mnt/data

    이는 해당 파일시스템을 사용 중인 모든 프로세스가 종료됐다는 의미가 아닙니다. 따라서 일반적인 장애 해결 방법으로 무조건 사용하는 것은 권장하지 않습니다.

    umount -f는 강제 해제 옵션이지만 모든 파일시스템에서 동일하게 동작하는 것은 아니며, 특히 응답하지 않는 네트워크 파일시스템 등에서 신중하게 검토해야 합니다.

    sudo umount -f /mnt/data

    운영 서버에서는 프로세스 점유 확인 → 서비스 정상 종료 → 하위 마운트 확인 → 일반 umount 재시도를 먼저 수행하고, Lazy 또는 강제 해제는 위험과 복구 절차를 이해한 경우에만 검토하는 것이 안전합니다.

    실전 점검 순서

    예를 들어 /mnt/data를 마운트 해제할 때 target is busy 오류가 발생했다면 다음 순서로 점검합니다.

    # 1. 마운트 구조 확인
    findmnt -R /mnt/data
    
    # 2. 사용 중인 프로세스 확인
    sudo fuser -vm /mnt/data
    
    # 3. 열린 파일 확인
    sudo lsof +D /mnt/data
    
    # 4. PID 확인 후 상세 정보 조회
    ps -fp 3180
    
    # 5. 현재 작업 위치 변경
    cd /
    
    # 6. 원인을 해결한 뒤 다시 마운트 해제
    sudo umount /mnt/data
    
    # 7. 마운트 해제 여부 확인
    findmnt -M /mnt/data

    위 명령에서 PID 3180은 예시이므로 실제 서버에서 확인한 PID로 변경해야 합니다. 또한 프로세스를 종료하거나 마운트를 해제하기 전에는 서비스 영향과 데이터 쓰기 상태를 반드시 확인해야 합니다.

    정리

    리눅스 서버에서 Device or Resource Busy 오류가 발생했다면 단순한 파일 권한 문제로 판단하기보다 어떤 작업에서 오류가 발생했는지와 어떤 프로세스 또는 마운트가 해당 자원을 사용 중인지 확인하는 것이 우선입니다.

    마운트 해제 오류라면 findmnt로 마운트 구조를 확인하고, fuser와 lsof로 사용 중인 프로세스를 추적합니다. 그다음 서비스의 정상 종료나 작업 디렉터리 변경 등으로 원인을 해결한 뒤 umount를 다시 실행하면 됩니다.

    특히 kill -9, umount -l, umount -f 같은 명령은 상황에 따라 운영 중인 서비스에 영향을 줄 수 있으므로 원인을 확인하지 않은 상태에서 바로 실행하지 않는 것이 중요합니다.
  • 리눅스 서버에서 Stale File Handle 오류가 발생하는 이유와 해결 방법

    리눅스 서버에서 Stale File Handle 오류가 발생하는 이유와 해결 방법

    리눅스 서버에서 NFS로 연결된 공유 디렉터리에 접근하려는데 갑자기 Stale file handle 오류가 나타나는 경우가 있습니다. 평소 정상적으로 사용하던 경로에서 ls, df, stat 명령어가 실패하거나, 파일을 읽고 쓰던 애플리케이션이 갑자기 파일 접근 오류를 기록하기도 합니다.

    특히 NFS 서버를 재시작하거나 공유 디렉터리를 이동한 뒤, 스토리지 볼륨을 교체하거나 백업 데이터를 복원한 이후에 이런 문제가 발생할 수 있습니다. 파일이 실제로 존재하는데도 접근할 수 없어 권한 문제나 디스크 장애로 오해하기 쉽습니다.

    하지만 Stale File Handle 오류는 클라이언트가 보유한 파일 식별 정보가 서버에서 더 이상 유효하지 않을 때 발생하는 경우가 많습니다. 즉, 경로 이름이 그대로 남아 있어도 해당 파일이나 디렉터리를 가리키던 기존 파일 핸들이 무효화된 상태일 수 있습니다.

    이때 무조건 서버를 재부팅하거나 공유 디렉터리를 삭제하면 운영 중인 서비스에 추가 장애가 발생할 수 있습니다. 특히 여러 애플리케이션이 같은 NFS 마운트를 사용한다면 마운트 해제 전에 프로세스 점유 상태를 확인해야 합니다.

    이번 글에서는 오류 발생 경로 확인 → NFS 마운트 상태 분석 → 파일 핸들 무효화 원인 점검 → 프로세스 점유 확인 → 안전한 마운트 복구 순서로 해결 방법을 살펴봅니다.

    Stale File Handle 핵심 명령어 한눈에 보기

    오류가 발생했다면 먼저 해당 디렉터리가 어떤 파일시스템에 연결되어 있는지, NFS 서버와 마운트 상태가 정상인지 확인해야 합니다. 아래 예시에서는 /mnt/shared를 NFS 마운트 경로로 사용합니다.

    점검 목적 명령어
    마운트 정보 확인 findmnt -t nfs,nfs4
    NFS 마운트 목록 mount -t nfs,nfs4
    NFS 서버 연결 확인 ping -c 4 192.0.2.10
    파일 접근 오류 확인 stat /mnt/shared
    점유 프로세스 확인 sudo fuser -vm /mnt/shared
    NFS 클라이언트 통계 nfsstat -m
    마운트 해제 sudo umount /mnt/shared
    마운트 재연결 sudo mount /mnt/shared

    중요한 점은 오류가 발생한 경로가 실제로 NFS 마운트인지 먼저 확인하는 것입니다. Stale File Handle은 NFS에서 대표적으로 발생하지만 파일 핸들을 사용하는 다른 파일시스템이나 스토리지 환경에서도 발생할 수 있습니다.

    또한 ping이 성공했다고 해서 NFS 서비스가 정상적으로 동작한다는 의미는 아닙니다. 서버 연결과 파일시스템 접근 상태를 구분해서 확인해야 합니다.

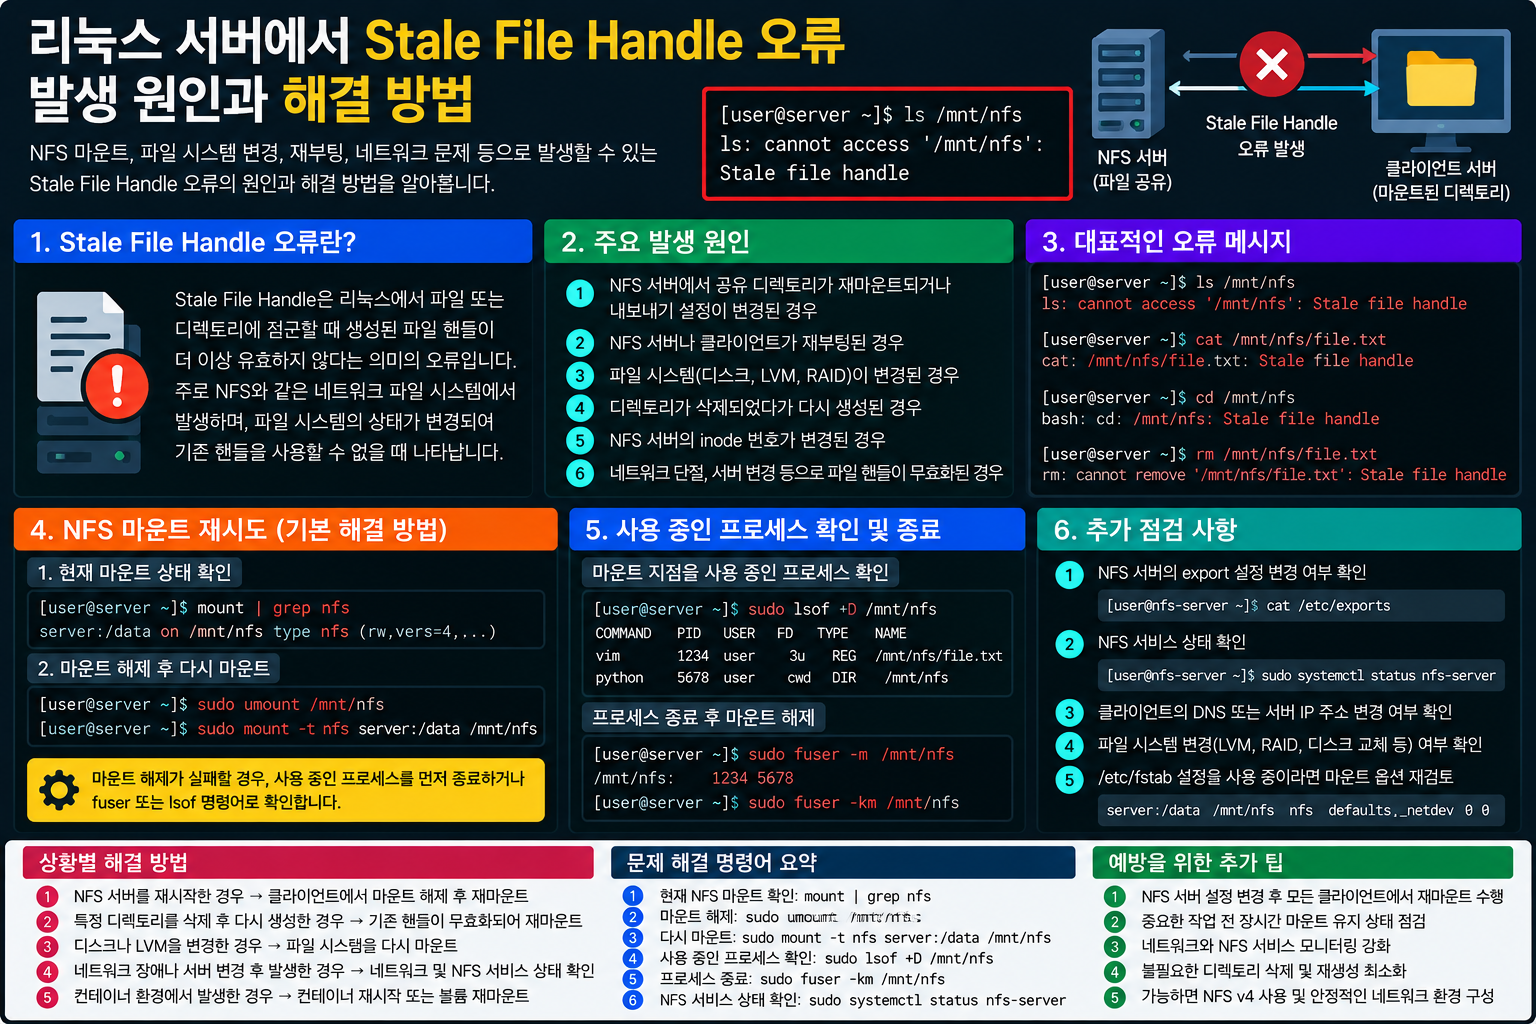
    리눅스 Stale File Handle 오류와 NFS 마운트 상태 확인 및 복구 방법
    NFS 공유 디렉터리에서 Stale File Handle 오류가 발생했을 때 마운트 상태와 프로세스 점유를 확인하는 예시입니다.

    1. Stale File Handle 오류가 발생하는 원인

    리눅스에서 Stale file handle은 일반적으로 ESTALE 오류와 관련이 있습니다.

    NFS 클라이언트는 원격 서버의 파일이나 디렉터리에 접근할 때 서버가 제공하는 파일 핸들을 사용합니다. 파일 핸들은 단순한 파일 이름이 아니라 서버가 해당 파일시스템 객체를 식별하기 위한 정보를 포함합니다.

    서버에서 파일이 삭제되거나 다른 객체로 교체되면 클라이언트가 이전에 저장한 파일 핸들이 더 이상 유효하지 않을 수 있습니다.

    대표적인 원인은 다음과 같습니다.

    • NFS 서버의 파일 변경: 기존 파일이나 디렉터리가 삭제되고 새 객체로 교체된 경우
    • 공유 디렉터리 재구성: NFS export 경로 또는 파일시스템 구성이 변경된 경우
    • 스토리지 복원: 스냅샷 복구나 볼륨 교체로 파일 식별 정보가 달라진 경우
    • 서버 재시작 후 변경: 재시작 과정에서 기존 파일 핸들이 더 이상 유효하지 않게 된 경우
    • 마운트 구성 변경: 클라이언트가 이전 파일시스템 객체를 계속 참조하는 경우
    • 애플리케이션의 오래된 참조: 프로세스가 삭제되거나 교체된 파일을 계속 사용하는 경우

    다만 NFS 서버를 재시작했다는 이유만으로 항상 Stale File Handle 오류가 발생하는 것은 아닙니다. 일반적인 서버 재시작 이후에도 기존 파일 핸들이 유효하게 유지될 수 있습니다.

    실제 원인은 서버의 파일시스템 객체나 export 구성이 어떻게 변경되었는지에 따라 달라집니다.

    2. 실제 Stale File Handle 오류 메시지 확인하기

    NFS 공유 디렉터리에서 문제가 발생하면 다음과 같은 메시지가 나타날 수 있습니다.

    $ ls -la /mnt/shared
    
    ls: cannot access '/mnt/shared':
    Stale file handle

    또는 특정 파일에 접근할 때 오류가 발생할 수 있습니다.

    $ stat /mnt/shared/report.csv
    
    stat: cannot statx '/mnt/shared/report.csv':
    Stale file handle

    이 메시지는 파일을 찾지 못했다는 No such file or directory 오류와 다릅니다.

    파일 이름이나 경로가 존재하는 것처럼 보여도 클라이언트가 참조하는 파일 핸들이 서버에서 더 이상 유효하지 않아 파일 정보를 조회하지 못하는 상황일 수 있습니다.

    특히 오류가 특정 파일에서만 발생하는지, 공유 디렉터리 전체에서 발생하는지 확인하면 문제 범위를 구분하는 데 도움이 됩니다.

    3. findmnt와 mount로 NFS 마운트 상태 확인하기

    가장 먼저 확인할 것은 오류가 발생한 경로가 어떤 원격 파일시스템에 연결되어 있는지입니다.

    findmnt -t nfs,nfs4

    다음은 출력 예시입니다.

    TARGET       SOURCE                 FSTYPE OPTIONS
    /mnt/shared  192.0.2.10:/exports/data nfs4   rw,relatime,vers=4.2

    주요 항목은 다음과 같습니다.

    • TARGET: 클라이언트의 마운트 경로
    • SOURCE: NFS 서버 주소와 공유 경로
    • FSTYPE: NFS 파일시스템 유형
    • OPTIONS: 적용된 마운트 옵션

    현재 마운트 목록을 확인하려면 다음 명령어도 사용할 수 있습니다.

    mount -t nfs,nfs4

    특정 경로의 마운트 정보를 확인할 때는 다음 명령어를 사용합니다.

    findmnt --mountpoint /mnt/shared

    단, 마운트 지점 자체가 아니라 하위 디렉터리에서 문제가 발생했다면 실제 경로에 적용되는 파일시스템을 별도로 확인해야 합니다.

    또한 findmnt에 마운트가 표시된다고 해서 NFS 서버가 현재 정상적으로 응답한다는 의미는 아닙니다.

    4. NFS 서버 연결과 커널 로그 점검하기

    NFS 서버와 통신이 불안정하면 파일 접근 오류나 응답 지연이 함께 발생할 수 있습니다.

    먼저 서버 연결 상태를 확인합니다.

    ping -c 4 192.0.2.10

    다만 ICMP가 차단된 환경에서는 ping이 실패해도 NFS 연결이 정상일 수 있습니다.

    NFSv4에서 일반적으로 사용하는 TCP 2049번 포트의 접근 가능 여부를 확인하려면 다음과 같이 사용할 수 있습니다.

    nc -vz -w 3 192.0.2.10 2049

    이 명령어는 TCP 포트 접근 가능 여부를 확인하는 것으로, NFS 파일 핸들의 유효성까지 검증하지는 않습니다.

    커널 로그에서도 관련 메시지를 검색합니다.

    sudo journalctl -k -b | grep -Ei 'nfs|stale|server not responding'

    예를 들어 다음과 같은 로그가 확인될 수 있습니다.

    nfs: server 192.0.2.10 not responding, still trying

    이 메시지는 서버 응답 지연이나 연결 문제를 나타낼 수 있지만 그 자체가 Stale File Handle의 직접적인 원인이라는 의미는 아닙니다.

    ESTALE 오류와 네트워크 타임아웃은 서로 다른 문제일 수 있으므로 로그 발생 시각과 서버 변경 이력을 함께 확인해야 합니다.

    5. NFS 마운트를 사용하는 프로세스 확인하기

    마운트를 해제하기 전에 해당 경로를 사용 중인 프로세스가 있는지 확인해야 합니다.

    sudo fuser -vm /mnt/shared

    다음은 설명을 위한 출력 예시입니다.

                         USER        PID ACCESS COMMAND
    /mnt/shared:         root       2451 ..c.. bash
                         app        3187 f.... python3

    여기서 PID는 프로세스 번호, COMMAND는 실행 중인 프로그램입니다.

    ACCESS 항목에서는 현재 작업 디렉터리나 열린 파일 등 마운트 사용 방식과 관련된 정보를 확인할 수 있습니다.

    다만 Stale File Handle 상태에서는 일부 파일 접근 및 프로세스 조회 명령어가 실패하거나 응답이 지연될 수 있습니다.

    운영 중인 데이터베이스, 웹 애플리케이션, 백업 프로세스가 해당 경로를 사용한다면 서비스 영향과 미완료 작업을 확인한 뒤 복구해야 합니다.

    6. NFS 마운트 해제와 재연결로 복구하기

    서버의 공유 경로와 파일시스템 구성이 정상이라는 사실을 확인했고, 마운트를 사용하는 서비스도 안전하게 중지할 수 있다면 마운트 해제와 재연결을 시도할 수 있습니다.

    먼저 해당 디렉터리에서 작업 중인 셸이나 프로세스를 정리합니다.

    그다음 정상적인 마운트 해제를 시도합니다.

    sudo umount /mnt/shared

    마운트 해제가 성공했다면 /etc/fstab에 해당 마운트가 등록되어 있는 경우 다음 명령어로 다시 연결할 수 있습니다.

    sudo mount /mnt/shared

    마운트가 복구됐는지 확인합니다.

    findmnt --mountpoint /mnt/shared
    ls -la /mnt/shared

    마운트 재연결은 클라이언트가 오래된 파일 핸들을 다시 획득하는 데 도움이 될 수 있지만, 서버의 export 설정이나 파일시스템 자체에 문제가 있다면 재마운트만으로 해결되지 않을 수 있습니다.

    또한 마운트 해제 이후에도 기존 파일 핸들을 보유한 애플리케이션은 정상적으로 복구되지 않을 수 있으므로 필요하다면 해당 애플리케이션을 안전하게 다시 시작해야 합니다.

    7. Device or Resource Busy 오류로 마운트 해제가 실패하는 경우

    NFS 마운트를 해제하려는데 다음과 같은 메시지가 나타날 수 있습니다.

    umount: /mnt/shared: target is busy.

    이는 해당 마운트를 사용 중인 프로세스나 하위 마운트 등이 존재할 때 발생할 수 있습니다.

    먼저 사용 중인 프로세스를 확인합니다.

    sudo fuser -vm /mnt/shared

    하위 마운트가 있는지도 확인합니다.

    findmnt -R /mnt/shared

    문제의 원인이 된 서비스를 확인한 뒤 가능하면 서비스 관리자를 통해 정상 종료해야 합니다.

    일반적인 프로세스라면 종료 가능 여부를 판단한 후 SIGTERM으로 정상 종료를 요청할 수 있습니다.

    kill -15 3187

    여기서 PID는 실제 확인된 프로세스 번호로 변경해야 합니다.

    kill -9는 마지막 수단이며, NFS I/O를 기다리는 프로세스가 커널의 인터럽트 불가능한 대기 상태에 있다면 즉시 종료되지 않을 수 있습니다.

    따라서 마운트가 사용 중이라는 이유만으로 모든 관련 프로세스를 강제 종료해서는 안 됩니다.

    8. umount -l 또는 umount -f를 사용해도 될까?

    마운트 해제가 실패할 때 다음 명령어를 해결 방법으로 소개하는 경우가 있습니다.

    sudo umount -l /mnt/shared

    -l은 lazy unmount 옵션입니다. 마운트 지점을 현재 파일시스템 네임스페이스에서 분리하고, 기존 참조가 해제되면 실제 정리가 완료되는 방식입니다.

    따라서 명령어가 성공했다고 해서 기존 프로세스가 보유한 파일 핸들이 즉시 모두 해제되거나 NFS 연결이 완전히 정상화됐다고 볼 수는 없습니다.

    다음 명령어는 강제 마운트 해제 옵션입니다.

    sudo umount -f /mnt/shared

    다만 -f의 동작은 파일시스템과 커널 구현에 따라 달라지며, NFS 연결이 응답하지 않는 상황에서도 항상 성공하는 것은 아닙니다.

    운영 서버에서는 정상적인 마운트 해제와 서비스 종료를 먼저 시도하고, lazy 또는 force 옵션은 복구 절차와 영향 범위를 충분히 확인한 뒤 마지막 수단으로 검토하는 것이 좋습니다.

    9. Stale File Handle 오류가 반복되는 경우 확인할 사항

    재마운트 후에도 오류가 반복된다면 클라이언트 문제가 아니라 NFS 서버의 파일시스템 구성이나 애플리케이션 동작 방식에 원인이 있을 수 있습니다.

    특히 다음 사항을 점검해야 합니다.

    • 공유 경로 변경: NFS export 디렉터리가 이동되거나 교체됐는지 확인
    • 파일시스템 교체: 서버의 공유 볼륨이 다른 파일시스템으로 변경됐는지 확인
    • 스냅샷 복원: 복원 과정에서 기존 파일 핸들이 무효화됐는지 확인
    • 애플리케이션 배포: 디렉터리를 삭제한 뒤 같은 이름으로 다시 생성하는 작업이 있는지 확인
    • 클러스터 구성: 여러 NFS 서버가 일관된 파일 핸들을 제공하는지 확인
    • 스토리지 로그: 서버 측 파일시스템 오류나 export 변경 기록 확인

    특히 디렉터리를 삭제한 뒤 같은 이름으로 다시 생성하는 배포 방식은 기존 디렉터리를 참조하던 클라이언트에 영향을 줄 수 있습니다.

    NFS 서버 관리 권한이 있다면 공유 설정과 실제 파일시스템 마운트 상태를 함께 점검해야 합니다.

    다만 NFS 서버의 export 설정을 무작정 변경하거나 서비스를 반복해서 재시작하면 다른 클라이언트에도 영향을 줄 수 있으므로 주의해야 합니다.

    실전 점검 순서

    리눅스 서버에서 Stale File Handle 오류가 발생했다면 다음 순서로 점검할 수 있습니다.

    # 1. NFS 마운트 목록 확인
    findmnt -t nfs,nfs4
    
    # 2. 오류 경로의 마운트 확인
    findmnt --mountpoint /mnt/shared
    
    # 3. 파일 접근 오류 확인
    stat /mnt/shared
    
    # 4. NFS 클라이언트 마운트 통계
    nfsstat -m
    
    # 5. 커널 로그 확인
    sudo journalctl -k -b | grep -Ei 'nfs|stale|server not responding'
    
    # 6. 마운트를 사용하는 프로세스 확인
    sudo fuser -vm /mnt/shared
    
    # 7. 하위 마운트 확인
    findmnt -R /mnt/shared
    
    # 8. 서비스 영향 확인 후 마운트 해제
    sudo umount /mnt/shared
    
    # 9. fstab에 등록된 마운트 재연결
    sudo mount /mnt/shared
    
    # 10. 복구 상태 확인
    findmnt --mountpoint /mnt/shared
    ls -la /mnt/shared

    위 명령어는 정상적인 NFS 서버 연결과 공유 경로 구성이 확인된 환경을 기준으로 작성한 예시입니다.

    실제 운영 환경에서는 마운트를 사용하는 애플리케이션을 먼저 확인하고, 데이터 손실이나 서비스 중단 가능성을 검토한 뒤 마운트 해제와 재연결을 진행해야 합니다.

    정리

    리눅스 서버에서 Stale File Handle 오류가 발생하는 이유는 대부분 클라이언트가 보유한 파일 핸들이 NFS 서버에서 더 이상 유효하지 않기 때문입니다.

    특히 공유 디렉터리 변경, 파일시스템 교체, 스냅샷 복원, 오래된 파일 참조 등이 대표적인 원인입니다.

    먼저 findmnt와 mount로 마운트 상태를 확인하고, fuser로 해당 경로를 사용하는 프로세스를 확인해야 합니다.

    서버 구성이 정상이고 서비스 중단이 가능한 상황이라면 마운트 해제 후 재연결을 시도할 수 있습니다. 하지만 서버의 파일시스템 객체나 export 구성이 변경된 상태라면 근본 원인을 먼저 해결해야 합니다.

    핵심 점검 순서는 오류 경로 확인 → NFS 상태 점검 → 서버 변경 이력 분석 → 프로세스 점유 확인 → 안전한 재마운트 → 재발 원인 제거입니다.