[카테고리:] Uncategorized

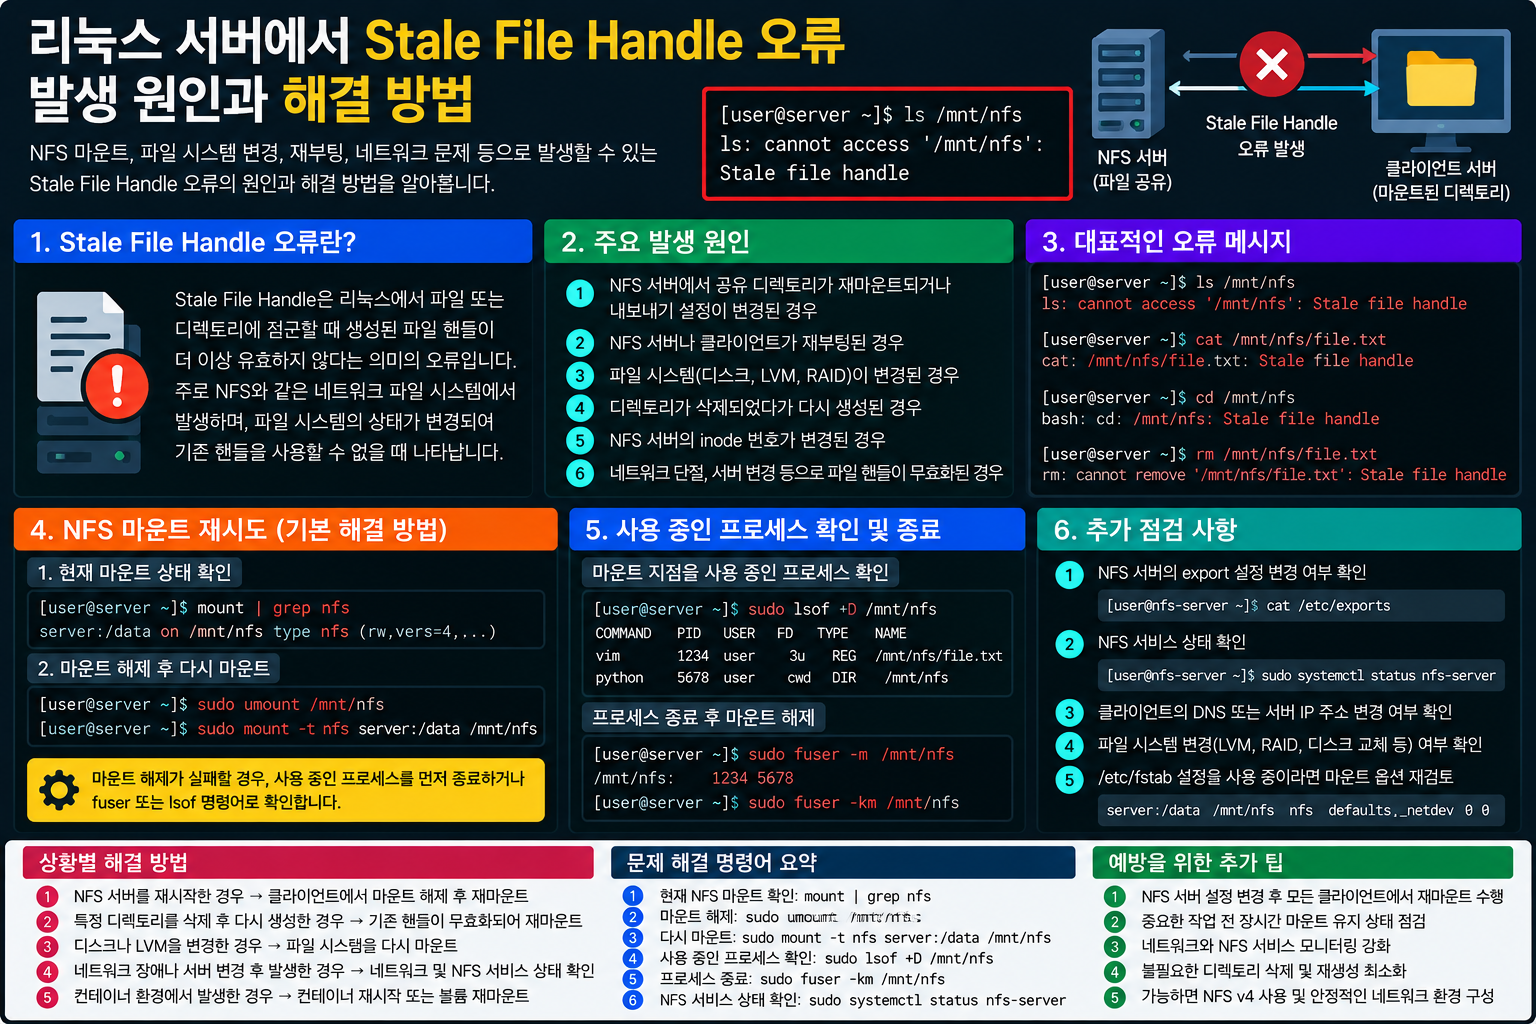
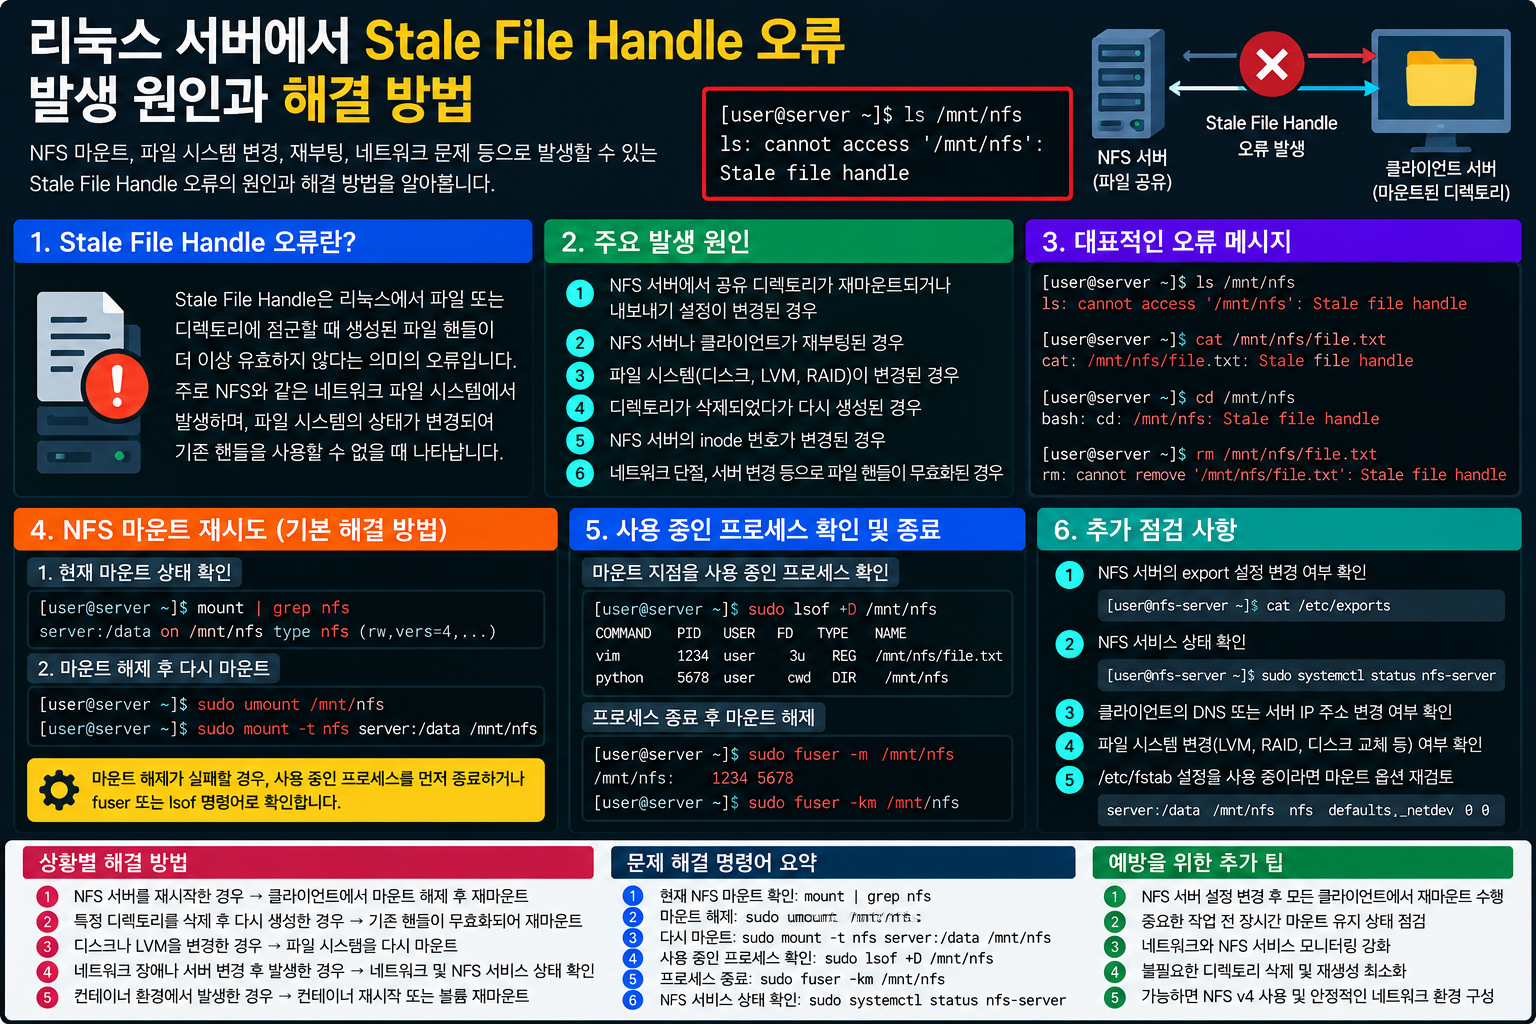
  • 리눅스 서버에서 Stale File Handle 오류가 발생하는 이유와 해결 방법

    리눅스 서버에서 Stale File Handle 오류가 발생하는 이유와 해결 방법

    리눅스 서버에서 평소 정상적으로 사용하던 공유 디렉터리에 접근하려는데 갑자기 Stale file handle 오류가 발생하는 경우가 있습니다. 파일을 삭제하거나 수정하지 않았는데도 ls, stat, df 명령어가 실패하거나 애플리케이션에서 파일을 읽지 못하는 현상이 나타날 수 있습니다.

    특히 NFS(Network File System)를 사용하는 서버에서는 공유 디렉터리를 변경하거나 스토리지 볼륨을 복원한 뒤 이러한 오류가 발생하기도 합니다. 파일이 존재하는 것처럼 보이는데 접근할 수 없어 파일 권한이나 네트워크 연결 문제로 오해하기 쉽습니다.

    하지만 Stale File Handle 오류는 클라이언트가 보유한 파일 식별 정보가 서버에서 더 이상 유효하지 않을 때 발생하는 경우가 많습니다. 단순히 네트워크를 다시 연결하거나 서버를 재시작한다고 해서 항상 해결되는 문제는 아닙니다.

    이번 글에서는 오류 메시지 확인 → NFS 마운트 상태 점검 → 파일 핸들 무효화 원인 분석 → 점유 프로세스 확인 → 안전한 재마운트 및 재발 방지 순서로 해결 방법을 알아봅니다.

    Stale File Handle 핵심 명령어 한눈에 보기

    오류가 발생했다면 먼저 해당 경로가 어떤 파일시스템에 연결되어 있는지 확인해야 합니다. 다음 명령어에서는 /mnt/shared를 NFS 마운트 경로로 가정합니다.

    점검 목적 명령어
    NFS 마운트 확인 findmnt -t nfs,nfs4
    마운트 정보 확인 findmnt --mountpoint /mnt/shared
    파일 접근 상태 확인 stat /mnt/shared
    NFS 클라이언트 통계 nfsstat -m
    커널 로그 확인 sudo journalctl -k -b
    점유 프로세스 확인 sudo fuser -vm /mnt/shared
    하위 마운트 확인 findmnt -R /mnt/shared
    마운트 해제 sudo umount /mnt/shared
    마운트 재연결 sudo mount /mnt/shared

    Stale File Handle 오류가 발생했다고 해서 즉시 마운트를 해제하면 안 됩니다. 먼저 해당 경로를 사용 중인 프로세스와 서비스 영향을 확인해야 합니다.
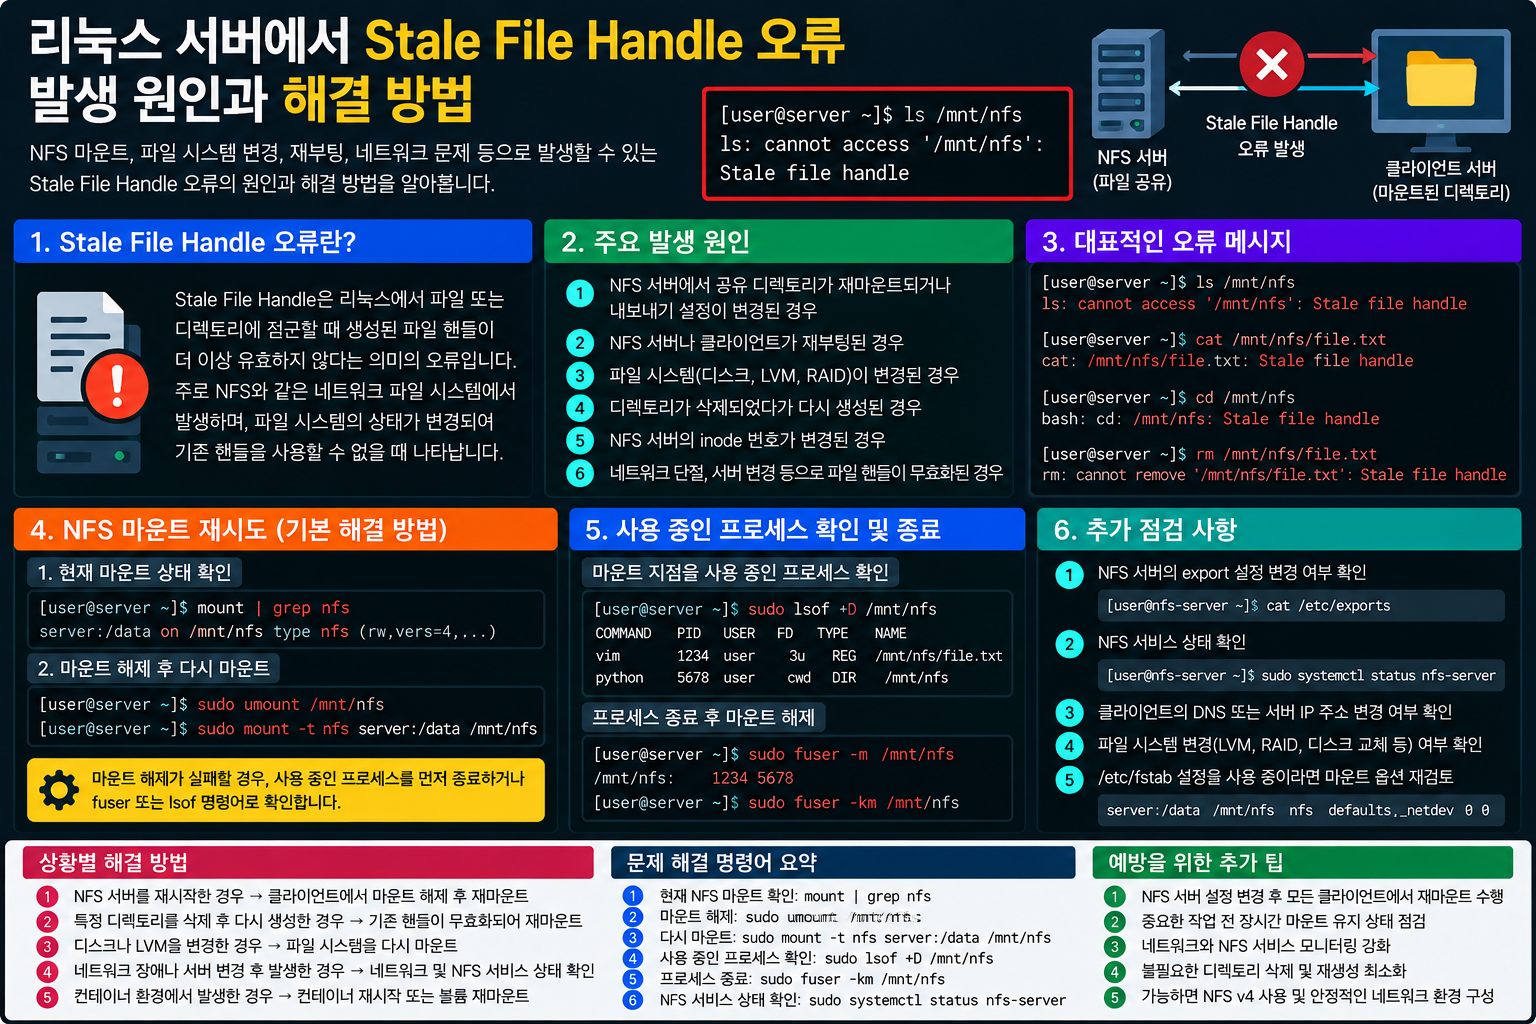
    리눅스 Stale File Handle 오류 발생 원인과 NFS 마운트 상태 확인 및 복구 방법
    리눅스 Stale File Handle 오류 발생 시 NFS 마운트 상태와 파일 핸들을 점검하는 방법

    1. Stale File Handle 오류가 발생하는 원인

    리눅스에서 Stale file handle은 일반적으로 ESTALE 오류 코드와 관련이 있습니다. 파일시스템에서 기존 파일 핸들이 더 이상 유효하지 않다고 판단할 때 반환될 수 있습니다.

    NFS 클라이언트는 서버에 저장된 파일이나 디렉터리에 접근할 때 파일 핸들이라는 식별 정보를 사용합니다. 이 정보는 단순한 파일 이름이 아니라 서버가 특정 파일시스템 객체를 식별하기 위해 사용하는 값입니다.

    예를 들어 서버에서 기존 디렉터리를 삭제하고 동일한 이름의 디렉터리를 다시 생성했다고 가정하겠습니다.

    # NFS 서버에서 실행하는 예시
    rm -r /exports/data/old-directory
    mkdir /exports/data/old-directory

    위 명령어는 원리를 설명하기 위한 예시이며, 실제 운영 서버에서 그대로 실행해서는 안 됩니다.

    새로 생성된 디렉터리는 이름이 같아도 기존 디렉터리와 다른 파일시스템 객체입니다. 따라서 클라이언트가 이전 디렉터리의 파일 핸들을 계속 사용한다면 Stale File Handle 오류가 발생할 수 있습니다.

    대표적인 발생 원인은 다음과 같습니다.

    • 공유 디렉터리 삭제 및 재생성: 기존 파일시스템 객체가 다른 객체로 교체된 경우
    • NFS Export 구성 변경: 공유 경로나 내보내기 구성이 달라진 경우
    • 스토리지 볼륨 교체: 공유 파일시스템이 다른 볼륨으로 변경된 경우
    • 스냅샷 복원: 파일 식별 정보가 이전 상태와 달라진 경우
    • 서버 재구성: 재시작 과정에서 파일시스템이나 공유 구성이 변경된 경우
    • 오래된 애플리케이션 참조: 프로세스가 유효하지 않은 파일 핸들을 계속 사용하는 경우

    단, NFS 서버를 단순히 재시작했다는 이유만으로 반드시 Stale File Handle 오류가 발생하는 것은 아닙니다. 기존 파일 핸들이 유지된다면 정상적으로 접근할 수 있습니다.

    2. 실제 오류 메시지와 발생 범위 확인하기

    NFS 공유 디렉터리에 접근할 때 다음과 같은 오류가 나타날 수 있습니다.

    $ ls -la /mnt/shared
    
    ls: cannot access '/mnt/shared':
    Stale file handle

    특정 파일에서만 오류가 발생하는 경우도 있습니다.

    $ stat /mnt/shared/report.csv
    
    stat: cannot statx '/mnt/shared/report.csv':
    Stale file handle

    이 오류는 파일이 없다는 의미의 No such file or directory와 구분해야 합니다.

    파일 이름이 동일하게 존재하더라도 클라이언트가 참조하는 파일 핸들이 더 이상 유효하지 않을 수 있습니다.

    오류가 발생했을 때는 다음 사항을 먼저 확인하는 것이 좋습니다.

    • 특정 파일에서만 오류가 발생하는지
    • 공유 디렉터리 전체에 접근할 수 없는지
    • 다른 NFS 클라이언트에서도 동일한 오류가 발생하는지
    • 오류 발생 직전에 서버의 공유 경로나 스토리지가 변경됐는지

    특정 파일에서만 발생한다면 해당 파일의 교체나 삭제 이력을, 공유 디렉터리 전체에서 발생한다면 마운트와 Export 구성을 우선 확인해야 합니다.

    3. findmnt로 NFS 마운트 상태 확인하기

    먼저 해당 서버에서 사용 중인 NFS 마운트 목록을 확인합니다.

    findmnt -t nfs,nfs4

    다음은 출력 예시입니다.

    TARGET       SOURCE                    FSTYPE OPTIONS
    /mnt/shared  192.0.2.10:/exports/data  nfs4   rw,relatime,vers=4.2

    주요 항목은 다음과 같습니다.

    • TARGET: 클라이언트에서 사용하는 마운트 경로
    • SOURCE: NFS 서버 주소와 공유 디렉터리
    • FSTYPE: 파일시스템 유형
    • OPTIONS: 마운트 옵션과 NFS 프로토콜 버전

    특정 마운트 지점을 확인하려면 다음 명령어를 사용합니다.

    findmnt --mountpoint /mnt/shared

    오류가 마운트 지점의 하위 경로에서 발생했다면 해당 경로에 적용되는 파일시스템도 확인할 수 있습니다.

    findmnt -T /mnt/shared/report.csv

    단, 파일 핸들이 이미 무효화된 상태에서는 경로를 직접 조회하는 명령어가 실패할 수도 있습니다.

    또한 findmnt에서 마운트가 정상적으로 표시되더라도 NFS 서버의 파일 핸들이 유효하다는 의미는 아닙니다. 마운트 정보와 실제 파일 접근 가능 여부를 함께 확인해야 합니다.

    4. NFS 서버 연결과 커널 로그 점검하기

    NFS 서버의 응답이 불안정하다면 파일 접근 오류나 장시간 대기 현상이 함께 나타날 수 있습니다.

    먼저 서버 연결 상태를 확인합니다.

    ping -c 4 192.0.2.10

    다만 ping이 성공해도 NFS 서비스가 정상이라는 의미는 아닙니다. 반대로 ICMP가 차단된 환경에서는 ping이 실패하더라도 NFS 통신은 정상일 수 있습니다.

    NFSv4에서 일반적으로 사용하는 TCP 2049번 포트의 연결 가능 여부를 확인할 수 있습니다.

    nc -vz -w 3 192.0.2.10 2049

    커널 로그에서 NFS 관련 메시지를 검색합니다.

    sudo journalctl -k -b | grep -Ei 'nfs|stale|server not responding'

    예를 들어 다음과 같은 메시지가 나타날 수 있습니다.

    nfs: server 192.0.2.10 not responding, still trying

    이 메시지는 NFS 서버 응답 문제를 나타낼 수 있습니다. 하지만 네트워크 타임아웃과 Stale File Handle은 서로 다른 원인으로 발생할 수 있으므로 구분해야 합니다.

    따라서 서버가 응답하는지만 확인할 것이 아니라 공유 디렉터리의 변경 이력과 실제 파일 접근 결과를 함께 점검해야 합니다.

    5. NFS 서버의 Export 설정 확인하기

    클라이언트에서 파일 핸들 오류가 반복된다면 NFS 서버의 공유 설정이 변경됐는지 확인해야 합니다.

    NFS 서버 관리 권한이 있는 경우 다음 명령어로 현재 Export 설정을 확인할 수 있습니다.

    sudo exportfs -v

    설정 파일도 확인할 수 있습니다.

    sudo cat /etc/exports

    예를 들어 다음과 같은 설정이 있을 수 있습니다.

    /exports/data 192.0.2.0/24(rw,sync,root_squash)

    여기서 확인할 사항은 다음과 같습니다.

    • 공유 경로가 이전과 동일한지
    • 해당 경로에 실제 파일시스템이 정상적으로 마운트되어 있는지
    • 스토리지 볼륨이나 파일시스템이 교체되지 않았는지
    • Export 설정 변경 이후 문제가 발생했는지
    • 여러 NFS 서버가 동일한 공유 경로를 제공하는 구조인지

    특히 서버에서 동일한 경로 이름을 유지하더라도 실제 파일시스템이 다른 볼륨으로 교체됐다면 기존 파일 핸들이 무효화될 수 있습니다.

    운영 중인 NFS 서버에서 Export 설정을 무작정 변경하거나 서비스를 재시작하면 다른 클라이언트에도 영향을 줄 수 있으므로 변경 이력을 먼저 확인하는 것이 중요합니다.

    6. fuser로 마운트를 사용하는 프로세스 확인하기

    마운트 해제나 재연결을 진행하기 전에 해당 디렉터리를 사용 중인 프로세스를 확인해야 합니다.

    sudo fuser -vm /mnt/shared

    다음은 출력 예시입니다.

                         USER        PID ACCESS COMMAND
    /mnt/shared:         root       2451 ..c.. bash
                         app        3187 f.... python3

    주요 항목은 다음과 같습니다.

    • USER: 프로세스를 실행한 사용자
    • PID: 프로세스 식별 번호
    • ACCESS: 파일이나 디렉터리 사용 상태
    • COMMAND: 실행 중인 프로그램

    예를 들어 bash가 해당 디렉터리를 현재 작업 경로로 사용하거나 Python 프로그램이 공유 파일을 열고 있을 수 있습니다.

    프로세스의 상세 정보를 확인하려면 다음 명령어를 사용합니다.

    ps -fp 3187

    서비스를 종료해야 한다면 해당 프로세스가 어떤 애플리케이션에 속하는지 확인하고 서비스 관리자를 통해 정상적으로 중지하는 것이 좋습니다.

    운영 서버에서는 fuser -km처럼 관련 프로세스를 일괄 종료하는 명령어를 원인 확인 없이 실행해서는 안 됩니다.

    7. NFS 마운트 해제 후 재연결하기

    NFS 서버의 공유 경로와 파일시스템이 정상이며 관련 서비스를 안전하게 중지할 수 있다면 마운트를 해제한 뒤 다시 연결하는 방법을 검토할 수 있습니다.

    먼저 현재 작업 디렉터리가 마운트 내부에 있다면 다른 경로로 이동합니다.

    cd /

    그다음 마운트 해제를 시도합니다.

    sudo umount /mnt/shared

    마운트 해제가 성공했다면 /etc/fstab에 등록된 경우 다음 명령어로 다시 연결합니다.

    sudo mount /mnt/shared

    재연결 후 상태를 확인합니다.

    findmnt --mountpoint /mnt/shared
    ls -la /mnt/shared

    만약 /etc/fstab에 등록되지 않았다면 실제 NFS 서버 주소와 공유 경로, 필요한 마운트 옵션을 확인한 뒤 명시적으로 마운트해야 합니다.

    sudo mount -t nfs4 192.0.2.10:/exports/data /mnt/shared

    위 명령어는 예시이며 실제 서버의 Export 경로와 NFS 버전에 맞게 변경해야 합니다.

    재마운트는 클라이언트가 새로운 파일 핸들을 얻는 데 도움이 될 수 있지만 서버 측 파일시스템이나 Export 구성이 잘못된 경우에는 근본 원인을 해결해야 합니다.

    8. Device or Resource Busy로 마운트 해제가 실패하는 경우

    NFS 마운트를 해제하려는데 다음과 같은 오류가 나타날 수 있습니다.

    umount: /mnt/shared: target is busy.

    이는 마운트 지점을 사용하는 프로세스가 있거나 하위 마운트가 존재할 때 발생할 수 있습니다.

    먼저 점유 프로세스를 확인합니다.

    sudo fuser -vm /mnt/shared

    하위 마운트도 확인합니다.

    findmnt -R /mnt/shared

    점유 프로세스를 확인했다면 정상적인 서비스 종료가 가능한지 먼저 판단해야 합니다.

    직접 실행한 일반 프로세스이며 종료해도 안전하다면 다음과 같이 정상 종료 신호를 보낼 수 있습니다.

    kill -15 3187

    여기서 PID는 실제 확인된 값으로 변경해야 합니다.

    반면 NFS I/O를 기다리는 프로세스가 커널의 인터럽트 불가능한 대기 상태에 있다면 종료 신호를 보내도 즉시 종료되지 않을 수 있습니다.

    따라서 강제 종료를 반복하기보다 NFS 서버 응답 상태와 파일시스템 상태를 함께 확인해야 합니다.

    9. umount -l과 umount -f 사용 시 주의사항

    일반적인 마운트 해제가 실패할 때 다음 명령어를 사용하는 방법이 소개되기도 합니다.

    sudo umount -l /mnt/shared

    -l은 Lazy Unmount 옵션입니다. 마운트 지점을 현재 마운트 네임스페이스에서 분리하고 기존 참조가 해제된 이후 정리가 완료되는 방식입니다.

    따라서 명령어가 성공하더라도 기존 프로세스가 사용하던 파일 핸들이 즉시 해제되거나 NFS 서버 연결 문제가 완전히 해결됐다는 의미는 아닙니다.

    강제 마운트 해제 옵션은 다음과 같습니다.

    sudo umount -f /mnt/shared

    하지만 -f는 파일시스템과 커널 동작에 따라 효과가 다를 수 있으며 모든 상황에서 성공하는 것은 아닙니다.

    특히 운영 서버에서는 미완료 파일 작업이나 애플리케이션의 데이터 접근 상태를 확인하지 않고 강제 마운트 해제를 실행하면 장애가 확대될 수 있습니다.

    가능하면 정상적인 서비스 종료와 일반 마운트 해제를 먼저 시도하고 Lazy 또는 Force 옵션은 마지막 복구 수단으로 검토해야 합니다.

    10. Stale File Handle 오류 재발 방지 방법

    재마운트 이후에도 오류가 반복된다면 NFS 서버와 애플리케이션의 파일 접근 구조를 점검해야 합니다.

    • 공유 디렉터리 변경 관리: 기존 디렉터리를 삭제하고 같은 이름으로 재생성하는 작업 최소화
    • 스토리지 교체 절차 수립: 볼륨 교체나 스냅샷 복원 전 클라이언트 영향 확인
    • NFS Export 설정 관리: 공유 경로와 파일시스템 변경 이력 기록
    • 애플리케이션 복구 처리: ESTALE 오류 발생 시 파일을 다시 열거나 연결을 재설정하도록 설계
    • 서버 로그 모니터링: NFS 오류와 스토리지 변경 기록 확인
    • 배포 방식 점검: 운영 중인 공유 디렉터리를 무분별하게 삭제하거나 교체하지 않도록 관리

    특히 NFS 서버에서 디렉터리를 삭제한 뒤 같은 이름으로 다시 만드는 배포 작업이 반복된다면 클라이언트가 이전 파일 핸들을 계속 참조하는 문제가 발생할 수 있습니다.

    이러한 환경에서는 파일과 디렉터리의 교체 방식, 애플리케이션의 재시도 처리, 공유 스토리지 운영 절차를 함께 개선해야 합니다.

    실전 점검 순서

    리눅스 서버에서 Stale File Handle 오류가 발생했다면 다음 순서로 원인을 확인할 수 있습니다.

    # 1. NFS 마운트 목록 확인
    findmnt -t nfs,nfs4
    
    # 2. 오류 경로의 마운트 확인
    findmnt --mountpoint /mnt/shared
    
    # 3. 파일 접근 오류 확인
    stat /mnt/shared
    
    # 4. NFS 마운트 통계 확인
    nfsstat -m
    
    # 5. 커널 로그 확인
    sudo journalctl -k -b | grep -Ei 'nfs|stale|server not responding'
    
    # 6. 점유 프로세스 확인
    sudo fuser -vm /mnt/shared
    
    # 7. 하위 마운트 확인
    findmnt -R /mnt/shared
    
    # 8. 서버 설정과 서비스 영향 확인 후 마운트 해제
    sudo umount /mnt/shared
    
    # 9. fstab에 등록된 경우 재마운트
    sudo mount /mnt/shared
    
    # 10. 복구 상태 확인
    findmnt --mountpoint /mnt/shared
    ls -la /mnt/shared

    위 명령어는 /mnt/shared가 실제 NFS 마운트 지점이며 NFS 서버의 공유 경로가 정상이라는 가정하에 작성한 예시입니다.

    운영 서버에서는 마운트를 사용하는 프로세스와 서비스 중단 가능성을 확인한 후 마운트 해제 및 재연결을 진행해야 합니다.

    정리

    리눅스 서버에서 Stale File Handle 오류가 발생하는 가장 대표적인 이유는 클라이언트가 보유한 파일 핸들이 NFS 서버에서 더 이상 유효하지 않기 때문입니다.

    공유 디렉터리 삭제 및 재생성, 스토리지 볼륨 교체, 스냅샷 복원, Export 설정 변경 등이 원인이 될 수 있습니다.

    먼저 findmnt로 마운트 정보를 확인하고 journalctl로 관련 로그를 분석한 뒤 fuser로 해당 경로를 사용하는 프로세스를 확인해야 합니다.

    서버의 공유 설정이 정상이고 서비스 중단이 가능한 상황이라면 안전하게 마운트를 해제하고 재연결할 수 있습니다. 다만 서버 측 파일시스템이나 Export 구성에 문제가 있다면 해당 원인을 먼저 해결해야 합니다.

    핵심 점검 순서는 오류 경로 확인 → NFS 마운트 상태 분석 → 서버 변경 이력 점검 → 점유 프로세스 확인 → 안전한 재마운트 → 재발 방지입니다.
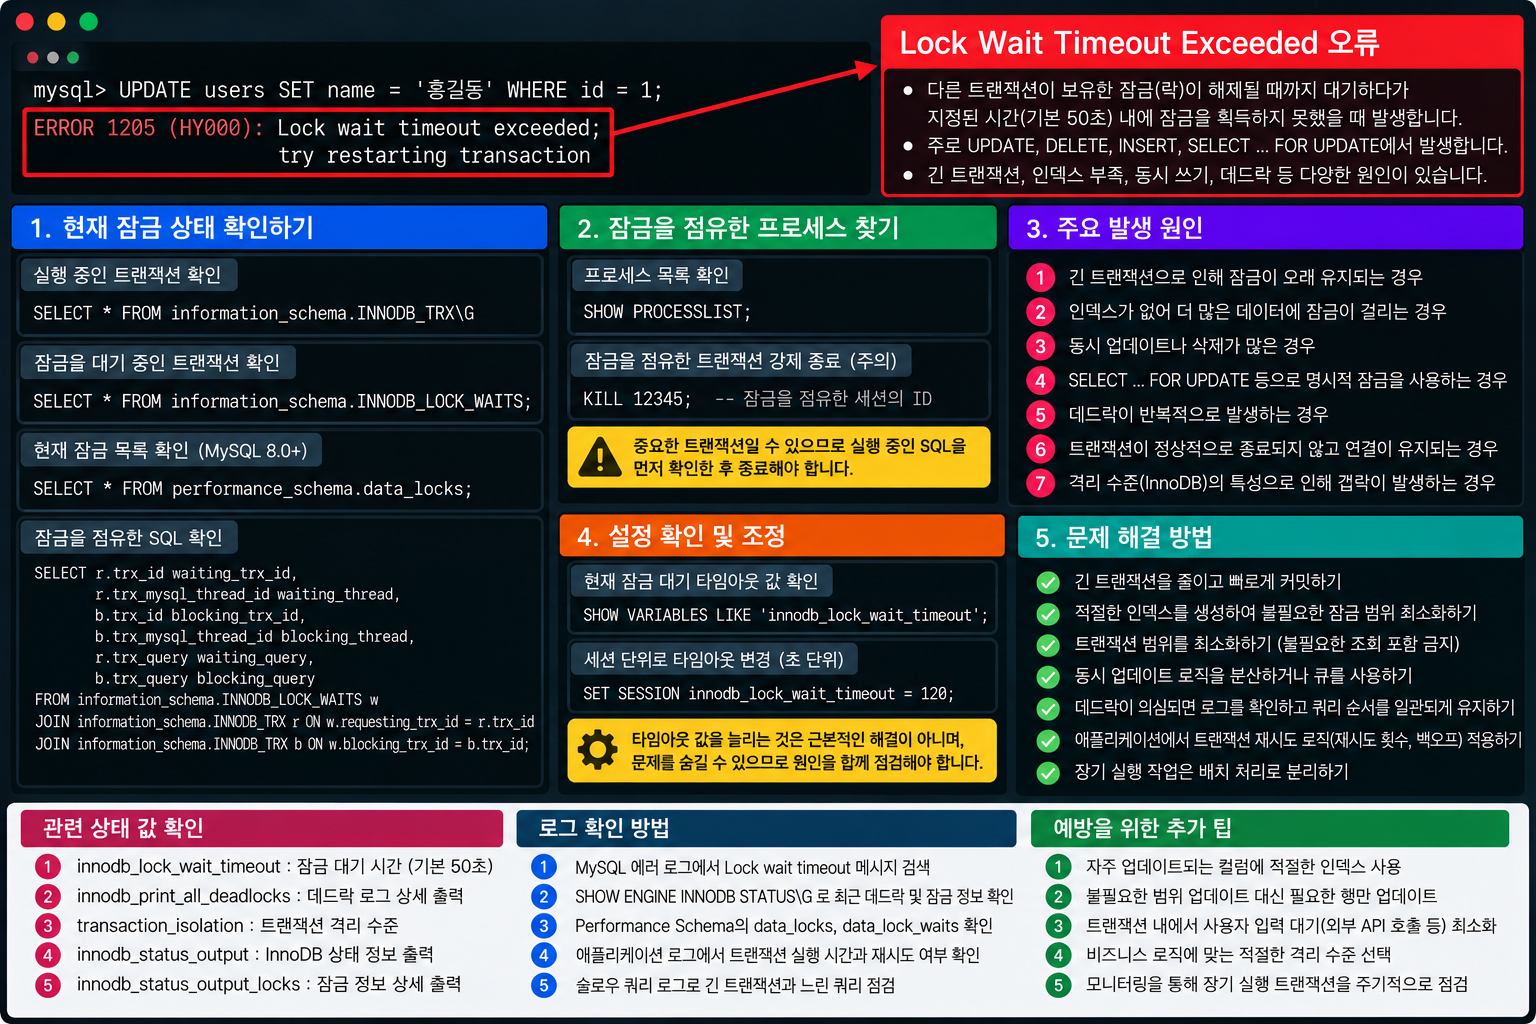
  • MySQL에서 Lock Wait Timeout Exceeded 오류가 발생하는 원인과 해결 방법

    MySQL에서 Lock Wait Timeout Exceeded 오류가 발생하는 원인과 해결 방법

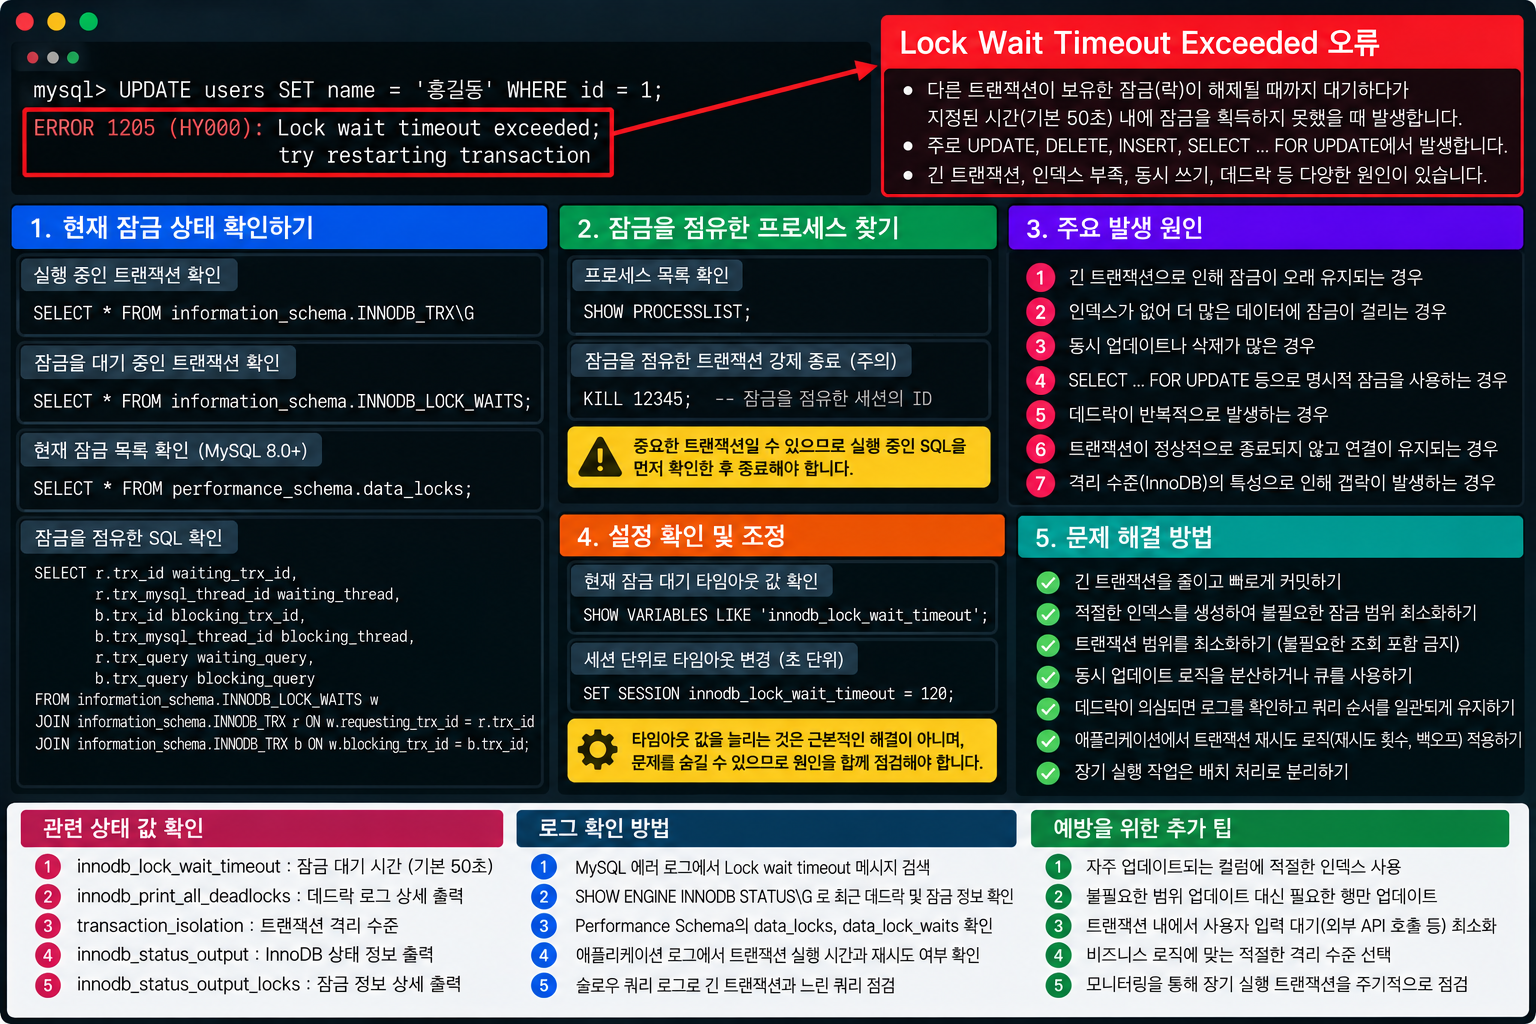
    MySQL에서 UPDATE나 DELETE 쿼리를 실행했는데 응답이 오랫동안 없거나, 일정 시간이 지난 뒤 Lock wait timeout exceeded; try restarting transaction 오류가 발생하는 경우가 있습니다. 특히 주문 정보 수정, 재고 차감, 회원 데이터 업데이트처럼 여러 사용자가 같은 데이터를 변경하는 환경에서 발생하기 쉽습니다.

    이 오류가 발생하면 데이터베이스 성능이 부족하거나 SQL 문법에 문제가 있다고 생각하기 쉽습니다. 하지만 대부분은 다른 트랜잭션이 보유한 잠금이 해제되기를 기다리다가 설정된 대기 시간을 초과했기 때문입니다.

    예를 들어 첫 번째 트랜잭션이 특정 주문 데이터를 수정한 뒤 COMMIT을 실행하지 않았다면, 다른 트랜잭션이 같은 데이터를 변경하려 할 때 잠금 대기 상태에 들어갈 수 있습니다. 이 상태가 오래 지속되면 MySQL은 오류 코드 1205를 반환합니다.

    이때 무조건 MySQL 서비스를 재시작하거나 innodb_lock_wait_timeout 값을 크게 늘리면 문제가 일시적으로 사라져도 실제 잠금 충돌은 계속될 수 있습니다.

    이번 글에서는 잠금 대기 확인 → 차단 트랜잭션 식별 → 원인 SQL 분석 → 안전한 트랜잭션 정리 → 재발 방지 순서로 Lock Wait Timeout Exceeded 오류를 해결하는 방법을 살펴봅니다.

    Lock Wait Timeout Exceeded 핵심 SQL 한눈에 보기

    MySQL에서 잠금 대기 오류가 발생했다면 먼저 현재 트랜잭션과 잠금 대기 관계를 확인해야 합니다. 아래 명령어는 주로 MySQL 8.0 환경을 기준으로 작성했습니다.

    점검 목적 SQL 명령어
    잠금 대기 시간 확인 SHOW VARIABLES LIKE 'innodb_lock_wait_timeout';
    현재 실행 세션 확인 SHOW FULL PROCESSLIST;
    InnoDB 트랜잭션 조회 SELECT * FROM information_schema.INNODB_TRX;
    잠금 대기 관계 조회 SELECT * FROM performance_schema.data_lock_waits;
    잠금 정보 조회 SELECT * FROM performance_schema.data_locks;
    InnoDB 상태 확인 SHOW ENGINE INNODB STATUS\G

    가장 중요한 것은 잠금을 기다리는 세션과 실제로 잠금을 보유한 세션을 구분하는 것입니다. 오류가 발생한 쿼리만 확인하면 다른 트랜잭션이 잠금을 장시간 유지하고 있다는 근본 원인을 놓칠 수 있습니다.

    MySQL Lock Wait Timeout Exceeded 오류와 InnoDB 트랜잭션 잠금 대기 확인 방법
    MySQL에서 Lock Wait Timeout Exceeded 오류가 발생했을 때 잠금을 보유한 트랜잭션과 대기 중인 세션을 확인하는 예시입니다.

    1. Lock Wait Timeout Exceeded 오류가 발생하는 이유

    MySQL InnoDB 스토리지 엔진은 여러 트랜잭션이 동시에 데이터를 변경할 때 데이터 일관성을 유지하기 위해 잠금 기능을 사용합니다.

    이 과정에서 다른 트랜잭션이 보유한 잠금과 충돌하면 해당 잠금이 해제될 때까지 기다리게 됩니다.

    대기 시간이 설정된 한도를 초과하면 다음 오류가 발생합니다.

    ERROR 1205 (HY000):
    Lock wait timeout exceeded; try restarting transaction

    대표적인 원인은 다음과 같습니다.

    • COMMIT 누락: 데이터 수정 후 트랜잭션을 종료하지 않은 경우
    • 장시간 트랜잭션: 하나의 트랜잭션에서 너무 많은 작업을 수행하는 경우
    • 동일 행 동시 수정: 여러 세션이 같은 레코드를 UPDATE하는 경우
    • 인덱스 부족: 비효율적인 검색으로 더 많은 레코드와 범위에 잠금이 발생하는 경우
    • 잠금 범위 확대: 격리 수준과 쿼리 조건에 따라 갭 락 또는 넥스트 키 락이 발생하는 경우
    • 애플리케이션 오류: 예외 발생 후 트랜잭션이 정리되지 않는 경우
    • DDL과의 충돌: ALTER TABLE 등에서 메타데이터 잠금을 기다리는 경우

    단, innodb_lock_wait_timeout은 일반적인 InnoDB 행 잠금 대기에 적용되며, 메타데이터 잠금 대기에는 별도의 lock_wait_timeout 설정이 사용됩니다.

    2. 두 트랜잭션이 충돌하는 실제 상황

    예를 들어 주문 테이블에서 같은 주문번호를 두 세션이 동시에 수정한다고 가정하겠습니다.

    먼저 첫 번째 세션에서 트랜잭션을 시작합니다.

    -- 세션 A
    START TRANSACTION;
    
    UPDATE orders
    SET status = 'processing'
    WHERE id = 1001;

    여기서 COMMIT을 실행하지 않고 트랜잭션을 유지합니다.

    이 상태에서 두 번째 세션이 동일한 행을 수정합니다.

    -- 세션 B
    START TRANSACTION;
    
    UPDATE orders
    SET status = 'completed'
    WHERE id = 1001;

    세션 B는 세션 A가 보유한 잠금이 해제되기를 기다립니다. 대기 시간이 초과되면 다음과 같은 오류가 발생할 수 있습니다.

    ERROR 1205 (HY000):
    Lock wait timeout exceeded; try restarting transaction

    세션 A에서 COMMIT 또는 ROLLBACK을 실행해 잠금을 해제하면 다른 세션이 해당 행에 접근할 수 있게 됩니다.

    중요한 점은 잠금 대기 시간이 초과됐다고 해서 기본 설정에서 트랜잭션 전체가 자동으로 롤백되는 것은 아니라는 사실입니다.

    기본적으로 InnoDB는 시간 초과가 발생한 명령문만 롤백합니다. 따라서 세션 B에서 이전에 실행한 변경 작업이 있다면 트랜잭션이 계속 열린 상태로 남을 수 있습니다.

    실패한 작업을 처음부터 다시 시도해야 한다면 애플리케이션에서 트랜잭션 전체를 ROLLBACK하고 새 트랜잭션으로 재시도하는 것이 일반적으로 안전합니다.

    3. SHOW FULL PROCESSLIST로 실행 중인 세션 확인하기

    잠금 대기가 발생했다면 먼저 MySQL에서 어떤 세션이 실행 중인지 확인합니다.

    SHOW FULL PROCESSLIST;

    출력에는 세션 ID, 사용자, 접속 호스트, 실행 상태와 SQL 정보 등이 표시됩니다.

    주요 항목은 다음과 같습니다.

    • Id: MySQL 연결 세션 ID
    • User: 연결 사용자
    • Host: 클라이언트 접속 정보
    • Command: Query 또는 Sleep 등 현재 명령 상태
    • Time: 현재 상태가 지속된 시간
    • State: 서버 내부 처리 상태
    • Info: 현재 실행 중인 SQL 문

    특히 Sleep 상태인 세션이라도 트랜잭션을 종료하지 않았다면 잠금을 유지할 수 있습니다.

    따라서 Sleep 세션을 모두 정상 상태로 판단하거나, 반대로 오래된 Sleep 세션을 무조건 종료하는 것은 적절하지 않습니다.

    4. INNODB_TRX로 장시간 열린 트랜잭션 찾기

    현재 실행 중인 InnoDB 트랜잭션은 다음 SQL로 조회할 수 있습니다.

    SELECT
        trx_id,
        trx_state,
        trx_started,
        trx_mysql_thread_id,
        trx_query
    FROM information_schema.INNODB_TRX
    ORDER BY trx_started;

    여기서 trx_started는 트랜잭션 시작 시각, trx_mysql_thread_id는 연결 세션 ID를 나타냅니다.

    trx_state가 LOCK WAIT라면 해당 트랜잭션이 잠금을 기다리는 상태일 수 있습니다.

    다만 오래된 트랜잭션이라고 해서 반드시 현재 발생한 잠금 충돌의 원인인 것은 아닙니다. 실제 차단 관계는 다음 단계에서 확인해야 합니다.

    5. Performance Schema로 잠금 대기 관계 확인하기

    MySQL 8.0에서는 performance_schema.data_lock_waits와 data_locks를 사용해 잠금 대기 관계를 확인할 수 있습니다.

    다음 SQL은 잠금을 기다리는 트랜잭션과 잠금을 차단하는 트랜잭션을 함께 조회하는 예시입니다.

    SELECT
        w.REQUESTING_ENGINE_TRANSACTION_ID AS waiting_trx_id,
        w.BLOCKING_ENGINE_TRANSACTION_ID AS blocking_trx_id,
        r.OBJECT_SCHEMA,
        r.OBJECT_NAME,
        r.INDEX_NAME,
        r.LOCK_TYPE AS waiting_lock_type,
        r.LOCK_MODE AS waiting_lock_mode,
        b.LOCK_MODE AS blocking_lock_mode
    FROM performance_schema.data_lock_waits AS w
    JOIN performance_schema.data_locks AS r
      ON w.REQUESTING_ENGINE_LOCK_ID = r.ENGINE_LOCK_ID
    JOIN performance_schema.data_locks AS b
      ON w.BLOCKING_ENGINE_LOCK_ID = b.ENGINE_LOCK_ID;

    이 결과를 통해 어느 테이블과 인덱스에서 잠금 충돌이 발생하고 있는지 확인할 수 있습니다.

    다만 이 SQL은 트랜잭션 ID와 잠금 정보를 보여주므로 실제 연결 세션을 종료하려면 세션 ID까지 확인해야 합니다.

    MySQL의 sys.innodb_lock_waits 뷰를 사용할 수 있는 환경이라면 더 간단하게 대기 세션과 차단 세션을 조회할 수 있습니다.

    SELECT
        waiting_pid,
        blocking_pid,
        locked_table,
        waiting_query,
        blocking_query
    FROM sys.innodb_lock_waits;

    여기서 blocking_pid는 차단 세션의 연결 ID입니다. 단, 해당 뷰가 설치되어 있고 필요한 조회 권한이 있어야 합니다.

    차단 트랜잭션이 현재 아무 SQL도 실행하지 않는 상태라면 blocking_query가 NULL일 수 있습니다. 이는 해당 트랜잭션이 잠금을 보유하지 않는다는 의미가 아닙니다.

    6. 차단 세션을 안전하게 종료하는 방법

    잠금 충돌의 원인이 되는 세션을 확인했다면 먼저 애플리케이션에서 해당 트랜잭션을 정상적으로 종료할 수 있는지 확인해야 합니다.

    정상적인 트랜잭션 종료 방법은 다음 두 가지입니다.

    COMMIT;
    ROLLBACK;

    단, 위 명령어는 현재 연결된 세션의 트랜잭션에 적용됩니다. 다른 세션에서 실행한다고 해서 차단 세션의 트랜잭션이 종료되는 것은 아닙니다.

    차단 세션이 응답하지 않고 운영상 종료가 필요하다고 판단된다면 관리 권한을 가진 계정에서 해당 연결을 종료할 수 있습니다.

    KILL CONNECTION 123;

    여기서 123은 실제 MySQL 연결 ID입니다. 트랜잭션 ID나 운영체제 PID를 입력하는 것이 아닙니다.

    연결이 종료되면 미완료 트랜잭션의 롤백이 진행될 수 있습니다. 대량의 변경 작업을 수행한 트랜잭션은 롤백에 시간이 걸릴 수 있습니다.

    또한 KILL QUERY는 현재 실행 중인 SQL을 중단하는 명령이며, 연결이나 트랜잭션 전체를 종료하는 명령과는 다릅니다.

    따라서 차단 세션을 종료하기 전에 실제 서비스와 연결된 작업인지, 데이터 변경 중인지, 종료 후 롤백 영향이 어느 정도인지 반드시 확인해야 합니다.

    7. innodb_lock_wait_timeout 값을 늘리면 해결될까?

    MySQL에서는 innodb_lock_wait_timeout으로 InnoDB 행 잠금 대기 시간을 설정할 수 있습니다.

    현재 값을 확인합니다.

    SHOW VARIABLES LIKE 'innodb_lock_wait_timeout';

    일반적인 기본값은 50초입니다. 다만 서버 버전과 운영 설정에 따라 실제 적용값은 다를 수 있습니다.

    특정 세션에서 임시로 값을 변경하려면 다음과 같이 실행할 수 있습니다.

    SET SESSION innodb_lock_wait_timeout = 30;

    이 설정은 현재 세션에 적용됩니다.

    하지만 잠금 대기 시간을 늘리는 것은 잠금 충돌 자체를 제거하는 해결 방법이 아닙니다.

    잠금을 보유한 트랜잭션이 오래 유지되는 상황이라면 대기 시간을 늘려도 응답 지연과 연결 누적이 심해질 수 있습니다.

    따라서 먼저 잠금 충돌 원인을 해결하고, 서비스의 정상적인 트랜잭션 처리 시간에 맞춰 적절한 대기 시간을 설정해야 합니다.

    8. 인덱스와 트랜잭션 구조 개선하기

    잠금 대기 오류가 반복된다면 SQL 실행 계획과 트랜잭션 범위를 점검해야 합니다.

    예를 들어 특정 주문번호를 수정하는 쿼리가 있다면 해당 조건에 적절한 인덱스가 있는지 확인합니다.

    EXPLAIN
    UPDATE orders
    SET status = 'completed'
    WHERE id = 1001;

    적절한 인덱스가 없다면 많은 레코드를 검사하면서 불필요하게 넓은 범위에 잠금이 발생할 수 있습니다.

    특히 InnoDB에서는 인덱스 검색 조건과 트랜잭션 격리 수준에 따라 레코드 락, 갭 락, 넥스트 키 락의 범위가 달라질 수 있습니다.

    다음 사항을 함께 점검하는 것이 좋습니다.

    • UPDATE와 DELETE 조건에 적절한 인덱스가 있는지 확인
    • 트랜잭션 안에서 외부 API 호출이나 장시간 작업을 수행하지 않도록 개선
    • 필요한 데이터만 수정하고 가능한 한 빠르게 COMMIT 실행
    • 여러 테이블을 수정할 때 일관된 잠금 획득 순서 유지
    • 대량 변경 작업을 적절한 크기의 배치로 분할
    • 잠금 대기 오류 발생 시 ROLLBACK 후 제한된 횟수로 재시도

    특히 자동 재시도 로직에서는 동일한 작업이 중복 처리되지 않도록 트랜잭션 경계와 멱등성을 고려해야 합니다.

    9. Lock Wait Timeout과 Deadlock의 차이

    잠금 대기 오류와 함께 자주 언급되는 문제가 Deadlock입니다. 하지만 두 오류는 발생 원리가 다릅니다.

    구분 Lock Wait Timeout Deadlock
    대표 오류 코드 1205 1213
    발생 원인 잠금 대기 시간 초과 트랜잭션 간 순환 대기
    대표 메시지 Lock wait timeout exceeded Deadlock found when trying to get lock
    기본 롤백 동작 시간 초과된 명령문 롤백 선택된 희생 트랜잭션 롤백
    우선 점검 장시간 트랜잭션과 차단 세션 잠금 획득 순서와 충돌 구조

    Deadlock은 트랜잭션들이 서로 상대방의 잠금 해제를 기다리는 순환 대기 상태입니다.

    반면 Lock Wait Timeout은 반드시 순환 대기가 발생한 것은 아니며, 다른 트랜잭션이 잠금을 너무 오래 유지해도 발생할 수 있습니다.

    따라서 두 오류를 구분해 로그와 트랜잭션 구조를 분석해야 합니다.

    실전 점검 순서

    MySQL에서 Lock Wait Timeout Exceeded 오류가 반복된다면 다음 순서로 확인할 수 있습니다.

    -- 1. 잠금 대기 시간 확인
    SHOW VARIABLES LIKE 'innodb_lock_wait_timeout';
    
    -- 2. 현재 세션 확인
    SHOW FULL PROCESSLIST;
    
    -- 3. 실행 중인 트랜잭션 확인
    SELECT
        trx_id,
        trx_state,
        trx_started,
        trx_mysql_thread_id,
        trx_query
    FROM information_schema.INNODB_TRX
    ORDER BY trx_started;
    
    -- 4. 잠금 대기 관계 확인
    SELECT
        waiting_pid,
        blocking_pid,
        locked_table,
        waiting_query,
        blocking_query
    FROM sys.innodb_lock_waits;
    
    -- 5. InnoDB 상태 확인
    SHOW ENGINE INNODB STATUS\G
    
    -- 6. 실제 차단 세션과 영향 확인 후
    -- 필요한 경우에만 연결 종료
    -- KILL CONNECTION 123;

    위 명령어는 MySQL 8.0에서 사용할 수 있는 대표적인 점검 예시입니다. 버전과 권한, Performance Schema 설정에 따라 조회 가능한 정보가 달라질 수 있습니다.

    특히 차단 세션을 발견했다고 해서 즉시 종료하지 말고 트랜잭션이 수행 중인 작업과 서비스 영향을 먼저 확인해야 합니다.

    정리

    MySQL에서 Lock Wait Timeout Exceeded 오류가 발생하는 이유는 대부분 다른 트랜잭션이 보유한 잠금이 해제되지 않아 설정된 대기 시간을 초과했기 때문입니다.

    먼저 SHOW FULL PROCESSLIST와 INNODB_TRX로 세션과 트랜잭션 상태를 확인하고, sys.innodb_lock_waits 또는 Performance Schema로 실제 차단 관계를 분석해야 합니다.

    잠금 대기 시간을 늘리거나 MySQL을 재시작하기보다 장시간 열린 트랜잭션, COMMIT 누락, 비효율적인 인덱스, 과도한 트랜잭션 범위를 개선하는 것이 근본적인 해결 방법입니다.

    핵심 점검 순서는 잠금 대기 확인 → 차단 세션 식별 → 원인 SQL 분석 → 안전한 트랜잭션 정리 → 인덱스와 애플리케이션 개선입니다.

  • Nginx에서 413 Request Entity Too Large 오류가 발생하는 이유

    Nginx에서 413 Request Entity Too Large 오류가 발생하는 이유

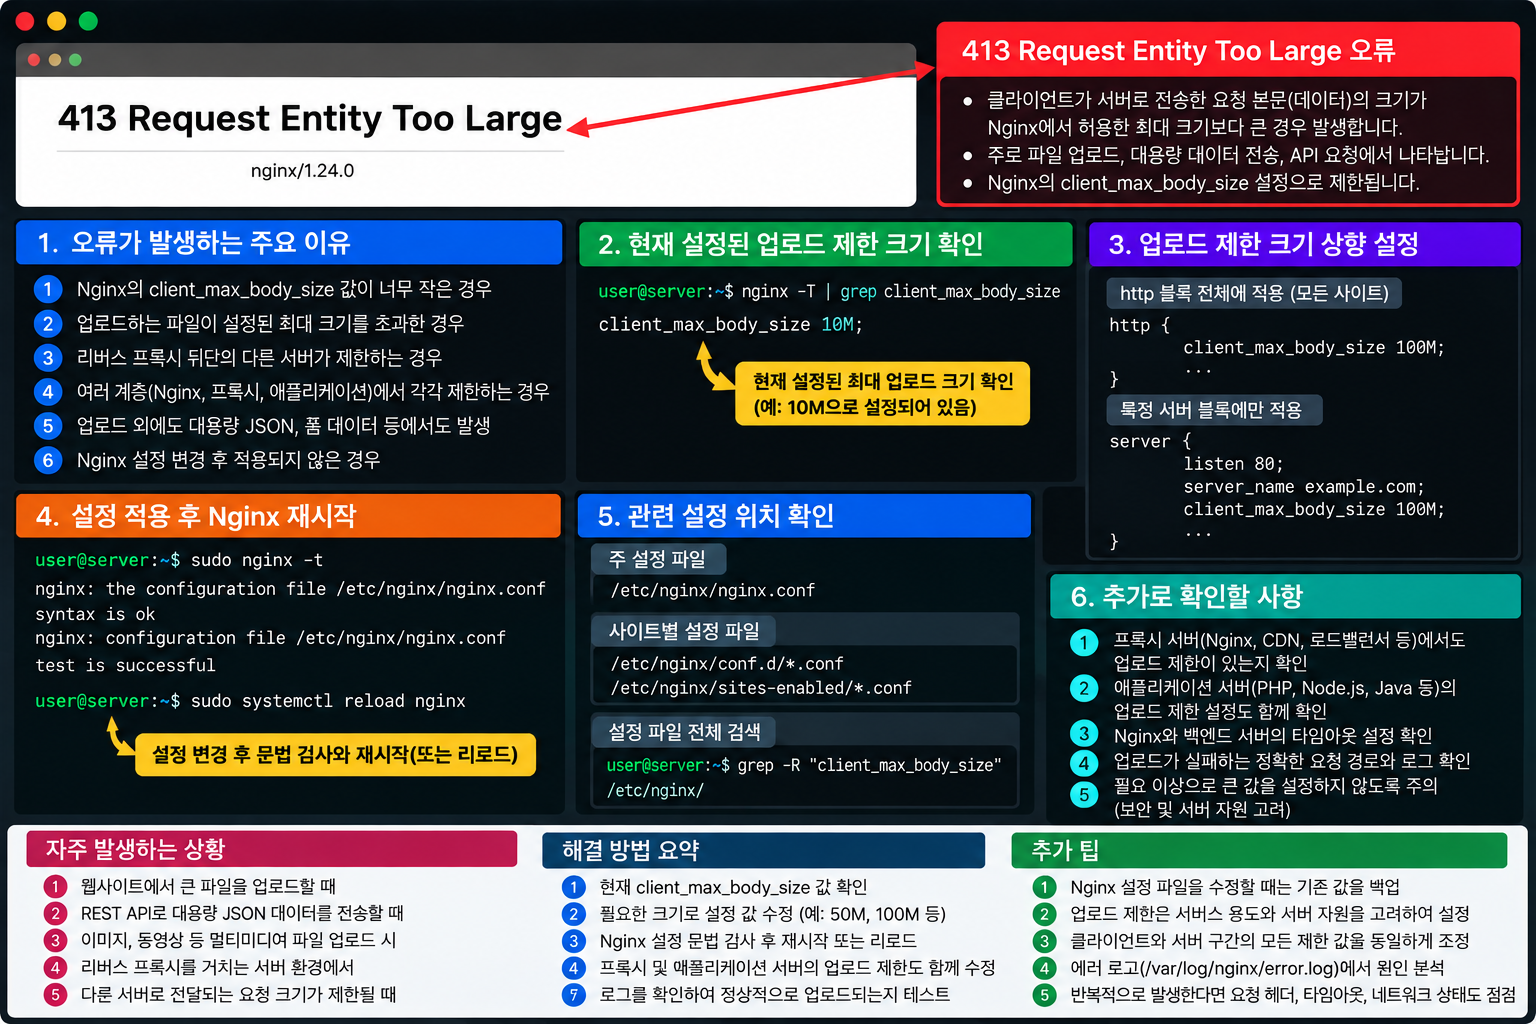
    Nginx 웹서버에서 이미지나 동영상, 압축파일을 업로드하려는데 갑자기 413 Request Entity Too Large 오류가 발생하는 경우가 있습니다. 작은 파일은 정상적으로 업로드되지만 특정 크기 이상의 파일만 실패하거나, API 요청을 보낼 때 413 상태 코드가 반환되는 현상도 나타날 수 있습니다.

    이런 오류가 발생하면 서버 저장 공간이 부족하거나 파일 권한에 문제가 있다고 생각하기 쉽습니다. 하지만 413 오류는 대부분 클라이언트가 전송한 HTTP 요청 본문(Request Body)의 크기가 서버 또는 중간 프록시에서 허용한 제한을 초과했을 때 발생합니다.

    특히 Nginx의 client_max_body_size 설정이 실제 업로드 크기보다 작거나, Nginx 앞단의 CDN·로드밸런서, 뒷단의 PHP·애플리케이션 서버가 별도의 용량 제한을 적용하고 있다면 설정을 한 곳만 변경해도 문제가 계속될 수 있습니다.

    이번 글에서는 413 오류 발생 위치 확인 → Nginx 업로드 제한 점검 → client_max_body_size 변경 → PHP 및 프록시 제한 확인 → 설정 검증 순서로 안전하게 해결하는 방법을 살펴봅니다.

    413 Request Entity Too Large 핵심 명령어 한눈에 보기

    413 오류가 발생했다면 아래 명령어로 Nginx 설정과 오류 로그를 먼저 확인할 수 있습니다.

    점검 목적 명령어
    Nginx 설정 문법 검사 sudo nginx -t
    현재 적용 설정 출력 sudo nginx -T
    업로드 제한 설정 검색 sudo nginx -T 2>&1 | grep -n client_max_body_size
    Nginx 오류 로그 확인 sudo tail -n 100 /var/log/nginx/error.log
    설정 다시 불러오기 sudo systemctl reload nginx
    PHP 업로드 제한 확인 php -i | grep -E 'upload_max_filesize|post_max_size'

    PHP CLI에서 조회한 설정과 실제 PHP-FPM 웹 요청에 적용되는 설정은 다를 수 있습니다. 따라서 PHP를 사용하는 환경에서는 웹 요청을 처리하는 PHP-FPM의 설정도 별도로 확인해야 합니다.

    Nginx 413 Request Entity Too Large 오류와 client_max_body_size 설정 확인 화면
    Nginx에서 413 오류가 발생했을 때 요청 본문 크기 제한과 client_max_body_size 설정을 확인하는 예시입니다.

    1. Nginx 413 오류가 발생하는 원인

    HTTP 413은 요청 본문의 크기가 서버에서 처리하도록 허용한 크기를 초과했다는 의미입니다. 현재 HTTP 표준에서는 413 Content Too Large라는 명칭을 사용하지만, Nginx 오류 페이지나 기존 문서에서는 413 Request Entity Too Large라는 표현도 널리 사용됩니다.

    대표적인 발생 원인은 다음과 같습니다.

    • Nginx 업로드 제한: client_max_body_size보다 큰 요청을 전송한 경우
    • PHP 제한: upload_max_filesize 또는 post_max_size가 부족한 경우
    • 애플리케이션 제한: Node.js, Django 등에서 요청 본문 크기를 제한한 경우
    • 프록시 제한: CDN, API Gateway 또는 로드밸런서에서 요청을 차단한 경우
    • 요청 크기 증가: 파일 외에 multipart 데이터나 JSON 본문이 추가된 경우
    • 설정 적용 오류: 다른 server 또는 location 블록의 설정이 적용되는 경우

    중요한 점은 413 오류가 반드시 Nginx 자체에서 생성된 것은 아니라는 사실입니다. 중간 프록시나 애플리케이션 서버가 413을 반환할 수도 있으므로 어느 계층에서 제한이 발생했는지 구분해야 합니다.

    2. 오류 로그에서 요청 크기 초과 여부 확인하기

    Nginx가 요청 본문을 차단했다면 오류 로그에 관련 메시지가 기록될 수 있습니다.

    sudo tail -n 100 /var/log/nginx/error.log

    대표적인 메시지는 다음과 같습니다.

    client intended to send too large body: 12582912 bytes

    위 예시는 클라이언트가 약 12MiB 크기의 요청 본문을 전송하려 했다는 의미입니다. 설정된 허용 크기보다 요청 본문이 크면 Nginx가 413 응답을 반환할 수 있습니다.

    다만 로그 파일의 위치는 배포판과 Nginx 설정에 따라 다르며, 로그 레벨이나 요청 처리 경로에 따라 같은 메시지가 남지 않을 수도 있습니다.

    따라서 Nginx 로그에 관련 기록이 없다면 앞단 프록시와 뒷단 애플리케이션 로그도 확인해야 합니다.

    3. client_max_body_size 설정 확인하기

    Nginx에서 HTTP 요청 본문의 최대 허용 크기를 제어하는 대표적인 지시어는 client_max_body_size입니다.

    Nginx의 기본값은 일반적으로 1m이며, 설정 파일에서 명시적으로 변경할 수 있습니다.

    sudo nginx -T 2>&1 | grep -n client_max_body_size

    이 명령어는 Nginx가 읽는 설정 파일들을 출력한 뒤 해당 지시어가 포함된 줄을 검색합니다.

    다만 검색 결과만으로 어떤 server 또는 location 블록에 설정이 적용되는지 확정할 수는 없습니다. 실제 요청을 처리하는 가상 호스트와 경로의 설정 구조를 확인해야 합니다.

    client_max_body_size는 http, server, location 컨텍스트에 지정할 수 있습니다. 하위 컨텍스트에서 별도로 설정하면 해당 범위의 값이 적용됩니다.

    4. Nginx 업로드 용량 제한 변경하기

    예를 들어 최대 50MiB의 요청 본문을 허용하려면 해당 사이트의 server 블록에 다음 설정을 추가할 수 있습니다.

    server {
        listen 80;
        server_name example.com;
    
        client_max_body_size 50m;
    
        # 기존 사이트 설정
    }

    특정 업로드 경로에만 제한을 적용하려면 해당 location 블록에 설정할 수도 있습니다.

    location /upload/ {
        client_max_body_size 50m;
    
        proxy_pass http://127.0.0.1:3000;
    }

    위 코드는 프록시를 사용하는 환경의 예시입니다. 실제 사이트에 이미 location 블록이 있다면 새 블록을 무작정 추가하지 말고 기존 요청 처리 설정에 맞춰 수정해야 합니다.

    또한 50m은 요청 본문 전체에 적용되는 제한입니다. multipart/form-data 업로드에서는 파일 내용 외에도 폼 필드와 구분자 등의 데이터가 포함되므로 파일 크기와 요청 본문 크기가 정확히 일치하지 않을 수 있습니다.

    따라서 최대 50MiB 파일을 허용하려는 목적이라면 실제 요청 본문 크기를 고려해 적절한 여유를 두는 것이 좋습니다.

    5. 설정을 수정했는데 413 오류가 계속 발생하는 경우

    client_max_body_size를 늘렸는데도 오류가 계속된다면 설정이 실제로 적용됐는지 먼저 확인해야 합니다.

    sudo nginx -t

    정상적인 경우 다음과 비슷한 결과가 표시됩니다.

    nginx: the configuration file /etc/nginx/nginx.conf syntax is ok
    nginx: configuration file /etc/nginx/nginx.conf test is successful

    설정 문법이 정상이라면 변경 사항을 다시 불러옵니다.

    sudo systemctl reload nginx

    이후 실제 적용된 설정을 확인합니다.

    sudo nginx -T

    다음 항목도 함께 점검해야 합니다.

    • 설정을 수정한 파일이 실제 Nginx에서 로드되는지
    • 요청 도메인이 올바른 server 블록과 일치하는지
    • 요청 경로에 다른 location 설정이 적용되는지
    • Docker 컨테이너 내부의 Nginx를 별도로 사용하고 있는지
    • CDN 또는 리버스 프록시가 앞단에서 요청을 제한하는지

    특히 여러 개의 Nginx 인스턴스나 프록시를 운영하는 환경에서는 한 서버의 설정만 변경해도 실제 요청이 다른 서버를 거칠 수 있습니다.

    6. PHP 업로드 제한도 함께 확인하기

    워드프레스처럼 PHP를 사용하는 웹사이트라면 Nginx 제한 외에도 PHP 업로드 설정을 확인해야 합니다.

    PHP 설정에서 주로 확인하는 항목은 다음과 같습니다.

    upload_max_filesize = 50M
    post_max_size = 60M

    upload_max_filesize는 개별 업로드 파일의 크기 제한이며, post_max_size는 POST 요청 데이터 전체의 크기 제한입니다.

    따라서 일반적으로 post_max_size는 upload_max_filesize보다 충분히 크게 설정해야 합니다. 여러 파일을 한 번에 업로드한다면 전체 요청 크기도 고려해야 합니다.

    또한 PHP의 memory_limit와 애플리케이션의 파일 처리 방식에 따라 별도의 메모리 문제가 발생할 수 있지만, 메모리 제한이 곧바로 Nginx의 413 오류를 의미하는 것은 아닙니다.

    PHP-FPM 설정을 수정했다면 해당 서비스의 설정을 검증하고 실제 PHP-FPM 서비스에 변경 사항을 반영해야 합니다. 서비스 이름은 설치된 PHP 버전에 따라 다릅니다.

    7. Node.js와 API 서버에서 발생하는 413 오류

    Nginx가 Node.js 애플리케이션으로 요청을 전달하는 구조에서는 Nginx 제한을 늘려도 애플리케이션에서 별도의 요청 크기 제한이 적용될 수 있습니다.

    예를 들어 Express의 JSON 요청 본문 파서는 다음과 같이 크기 제한을 설정할 수 있습니다.

    app.use(express.json({ limit: '10mb' }));

    이 경우 Nginx에서 50MiB를 허용하더라도 JSON 본문이 애플리케이션의 10MB 제한을 초과하면 요청이 거부될 수 있습니다.

    다만 JSON 본문 제한과 multipart 파일 업로드 제한은 서로 다른 미들웨어에서 처리될 수 있으므로 구분해야 합니다.

    실제 413 응답이 Nginx에서 생성된 것인지 애플리케이션에서 생성된 것인지 로그와 응답 내용을 비교하는 것이 중요합니다.

    8. client_max_body_size를 무제한으로 설정해도 될까?

    Nginx에서는 다음과 같이 설정할 수 있습니다.

    client_max_body_size 0;

    이 값은 Nginx의 요청 본문 크기 검사를 비활성화합니다. 하지만 무제한 업로드를 허용하면 서버 자원 사용량과 악의적인 대용량 요청에 대한 위험이 커질 수 있습니다.

    따라서 운영 환경에서는 가능한 한 서비스에 필요한 업로드 크기를 기준으로 적절한 상한을 설정하는 것이 좋습니다.

    또한 업로드 제한을 높일 때는 디스크 용량, 임시 파일 저장 경로, 업로드 처리 시간, 애플리케이션 검증 및 접근 제어도 함께 고려해야 합니다.

    실전 점검 순서

    Nginx에서 413 Request Entity Too Large 오류가 발생했다면 다음 순서로 점검할 수 있습니다.

    # 1. Nginx 오류 로그 확인
    sudo tail -n 100 /var/log/nginx/error.log
    
    # 2. 현재 업로드 제한 설정 검색
    sudo nginx -T 2>&1 | grep -n client_max_body_size
    
    # 3. 실제 가상 호스트와 location 설정 확인
    sudo nginx -T
    
    # 4. 설정 수정 후 문법 검사
    sudo nginx -t
    
    # 5. 정상일 때 설정 다시 불러오기
    sudo systemctl reload nginx
    
    # 6. PHP 사용 환경의 제한 확인
    php -i | grep -E 'upload_max_filesize|post_max_size'
    
    # 7. 오류 로그 재확인
    sudo tail -n 100 /var/log/nginx/error.log

    PHP CLI의 설정 조회는 참고용이며, PHP-FPM을 사용하는 경우에는 실제 웹 요청에 적용되는 설정을 별도로 확인해야 합니다.

    설정 변경 후에는 기존에 실패했던 파일과 허용 크기보다 큰 테스트 파일을 각각 업로드해 제한이 의도한 대로 동작하는지 확인하는 것이 좋습니다.

    정리

    Nginx에서 413 Request Entity Too Large 오류가 발생하는 가장 대표적인 이유는 요청 본문의 크기가 서버에서 허용한 제한을 초과했기 때문입니다.

    Nginx가 요청을 차단했다면 client_max_body_size 설정을 확인하고, PHP 또는 애플리케이션이 요청을 처리하는 환경에서는 각 계층의 업로드 제한도 함께 점검해야 합니다.

    특히 Nginx 설정을 변경했는데도 413 오류가 계속된다면 다른 server·location 설정, CDN·로드밸런서, 애플리케이션 자체 제한을 확인해야 합니다.

    핵심은 오류 발생 위치 확인 → 요청 크기 제한 점검 → 필요한 범위만 설정 변경 → nginx -t 검증 → 실제 업로드 테스트 순서를 지키는 것입니다.

  • SSH 접속 시 Host Key Verification Failed 오류가 발생하는 이유

    SSH 접속 시 Host Key Verification Failed 오류가 발생하는 이유

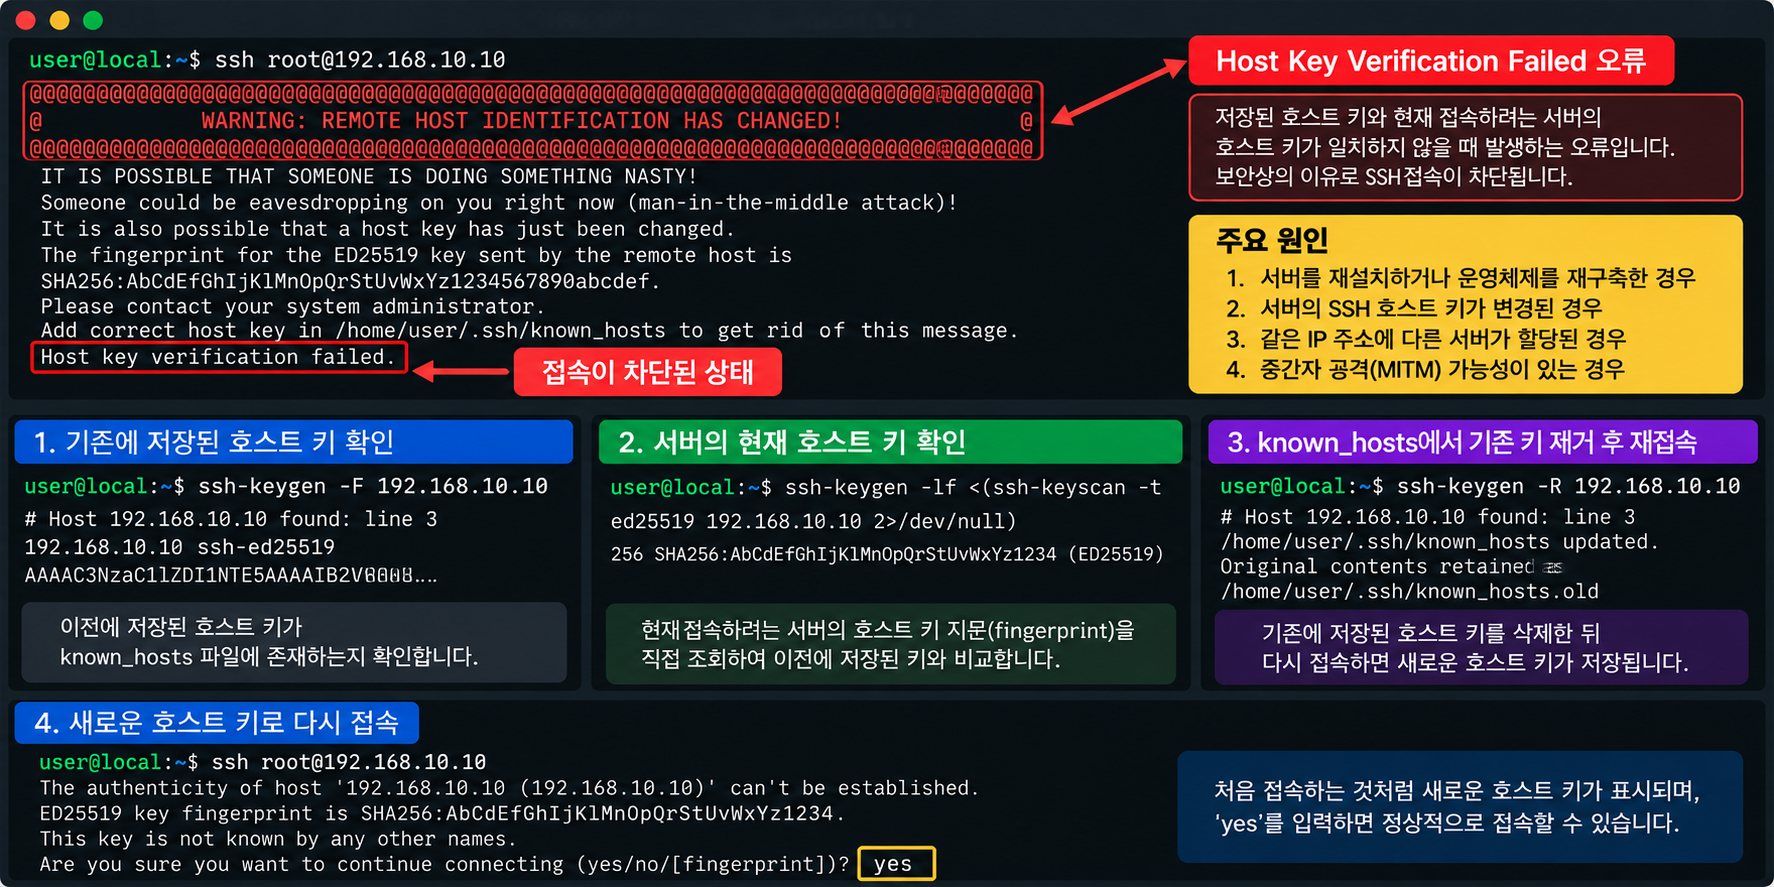
    SSH로 정상 접속하던 리눅스 서버에 다시 연결하려는데 갑자기 WARNING: REMOTE HOST IDENTIFICATION HAS CHANGED!라는 경고와 함께 Host Key Verification Failed 오류가 발생한 경험이 있으신가요? 서버를 재설치하거나 클라우드 인스턴스를 교체한 뒤, 또는 동일한 IP 주소에 다른 서버를 연결한 이후에 이런 문제가 발생할 수 있습니다.

    서버는 정상적으로 실행 중이고 네트워크 연결에도 문제가 없어 보이는데 SSH 접속만 거부되면 비밀번호나 SSH 포트 설정부터 확인하기 쉽습니다. 하지만 이 오류는 대부분 사용자 계정 인증 이전에 수행되는 서버 신원 확인 과정에서 문제가 발견됐다는 의미입니다.

    SSH 클라이언트는 이전에 접속했던 서버의 공개 호스트 키를 known_hosts 파일에 저장하고, 다음 접속에서 서버가 제시하는 키와 비교합니다. 저장된 키와 현재 서버의 키가 다르면 서버가 실제로 교체된 것인지, 설정이 변경된 것인지, 또는 다른 서버로 연결되고 있는지 확인해야 합니다.

    이때 인터넷에서 찾은 명령어로 known_hosts를 무조건 삭제하거나 호스트 키 검증 기능을 끄는 것은 안전한 해결 방법이 아닙니다. 이번 글에서는 오류 메시지 확인 → 저장된 호스트 키 조회 → 서버 신원 검증 → 문제가 있는 항목 수정 → SSH 재접속 순서로 해결 방법을 살펴봅니다.

    SSH Host Key Verification Failed 핵심 명령어 한눈에 보기

    SSH 호스트 키 오류가 발생했다면 아래 명령어로 저장된 키와 연결 상태를 확인할 수 있습니다. 예제의 192.0.2.10은 설명용 IP 주소이므로 실제 서버 주소로 변경해야 합니다.

    점검 목적 명령어
    SSH 상세 오류 확인 ssh -vvv user@192.0.2.10
    저장된 호스트 키 검색 ssh-keygen -F 192.0.2.10
    기존 호스트 키 항목 제거 ssh-keygen -R 192.0.2.10
    비표준 포트 키 항목 제거 ssh-keygen -R '[192.0.2.10]:2222'
    서버의 ED25519 키 지문 확인 sudo ssh-keygen -lf /etc/ssh/ssh_host_ed25519_key.pub

    주의할 점은 ssh-keygen -R 명령어를 실행하기 전에 서버의 호스트 키가 변경된 이유와 새 키의 지문을 신뢰할 수 있는 경로로 확인해야 한다는 것입니다. 저장된 키를 삭제하는 작업 자체가 새 서버의 신원을 보증하지는 않습니다.

    SSH Host Key Verification Failed 오류와 REMOTE HOST IDENTIFICATION HAS CHANGED 경고 화면
    SSH 접속 시 저장된 서버 호스트 키와 현재 서버의 키가 일치하지 않을 때 표시되는 경고 메시지 예시입니다.

    1. Host Key Verification Failed 오류가 발생하는 원인

    SSH는 암호화된 연결을 만드는 과정에서 접속 대상 서버의 신원을 확인합니다. 이때 사용하는 것이 서버의 SSH Host Key입니다. 사용자의 로그인에 사용하는 SSH 개인 키와는 역할이 다릅니다.

    클라이언트는 이전에 신뢰한 서버의 공개 호스트 키를 일반적으로 ~/.ssh/known_hosts에 저장합니다. 이후 동일한 서버 주소로 연결할 때 현재 서버가 제시한 키와 비교합니다.

    대표적인 오류 원인은 다음과 같습니다.

    • 서버 재설치: 운영체제 재설치 과정에서 SSH 호스트 키가 새로 생성된 경우
    • 클라우드 인스턴스 교체: 동일한 IP에 새로운 가상 서버가 연결된 경우
    • SSH 호스트 키 교체: 보안 정책이나 관리 작업으로 서버 키가 변경된 경우
    • DNS 또는 IP 변경: 기존 서버가 아닌 다른 서버로 연결되는 경우
    • known_hosts 문제: 오래된 키, 잘못된 항목 또는 신뢰할 수 없는 키가 저장된 경우
    • 보안 위협: 중간자 공격이나 연결 경로 변조 가능성이 있는 경우

    특히 중요한 것은 호스트 키 불일치가 반드시 공격을 의미하지는 않지만, 공격 가능성을 배제할 수 있는 오류도 아니라는 점입니다.

    따라서 최근 서버 교체 이력이 없는데 갑자기 키가 달라졌다면 기존 항목을 삭제하기 전에 서버 관리자나 클라우드 콘솔 등을 통해 원인을 확인해야 합니다.

    2. SSH 오류 메시지에서 확인해야 할 부분

    호스트 키가 변경된 서버에 접속하면 다음과 비슷한 경고가 나타날 수 있습니다.

    $ ssh user@192.0.2.10
    
    @@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@
    @ WARNING: REMOTE HOST IDENTIFICATION HAS CHANGED! @
    @@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@@
    
    IT IS POSSIBLE THAT SOMEONE IS DOING SOMETHING NASTY!
    The fingerprint for the ED25519 key sent by the remote host is
    SHA256:EXAMPLE_FINGERPRINT_NOT_A_REAL_KEY
    
    Offending ED25519 key in /home/user/.ssh/known_hosts:12
    Host key verification failed.

    위 내용은 설명을 위해 일부를 간략화한 출력 예시입니다. 실제 메시지의 문구와 순서는 OpenSSH 버전 및 설정에 따라 달라질 수 있습니다.

    여기서 가장 중요한 정보는 다음 세 가지입니다.

    • ED25519: 서버가 제시한 호스트 키의 알고리즘
    • SHA256 지문: 현재 연결 대상 서버가 제시한 키의 식별값
    • known_hosts:12: 충돌이 감지된 저장 키의 파일 위치와 줄 번호

    이 메시지가 나타났다면 SSH 클라이언트가 기존에 저장된 서버 신원과 현재 연결 대상의 신원이 일치하지 않는다고 판단한 것입니다.

    이 단계에서 바로 known_hosts 파일 전체를 삭제하기보다 문제가 발생한 호스트와 해당 키를 확인하는 것이 좋습니다.

    3. known_hosts 파일에 저장된 서버 키 확인하기

    OpenSSH는 사용자가 신뢰한 서버 호스트 키를 일반적으로 ~/.ssh/known_hosts 파일에 저장합니다.

    특정 IP 주소에 저장된 항목을 검색하려면 다음 명령어를 사용합니다.

    ssh-keygen -F 192.0.2.10

    이 명령어는 해시 처리된 호스트 이름이 저장된 경우에도 해당 호스트의 항목을 검색하는 데 사용할 수 있습니다.

    SSH 접속에 2222번과 같은 비표준 포트를 사용했다면 호스트와 포트를 함께 지정해야 할 수 있습니다.

    ssh-keygen -F '[192.0.2.10]:2222'

    기존 항목을 직접 확인하려면 다음 명령어를 사용할 수도 있습니다.

    cat ~/.ssh/known_hosts

    다만 파일에는 여러 서버의 키가 저장되어 있을 수 있고, 호스트 이름이 해시 처리되어 있다면 내용을 직접 읽어도 어떤 서버인지 구분하기 어렵습니다.

    따라서 특정 서버의 키를 확인할 때는 ssh-keygen -F 명령어를 우선 사용하는 것이 편리합니다.

    4. 서버의 새로운 호스트 키 지문을 안전하게 확인하기

    기존 키를 수정하기 전에 가장 중요한 작업은 현재 접속하려는 서버가 실제로 신뢰할 수 있는 서버인지 확인하는 것입니다.

    서버에 클라우드 제공업체의 웹 콘솔, 가상 머신 콘솔 또는 별도의 관리 경로로 접근할 수 있다면 해당 서버에서 직접 호스트 공개 키의 지문을 확인할 수 있습니다.

    sudo ssh-keygen -lf /etc/ssh/ssh_host_ed25519_key.pub

    출력되는 SHA256 지문을 SSH 클라이언트가 보여준 지문과 비교합니다. 두 지문이 일치하고 서버 변경 사유도 확인됐다면 새로운 호스트 키를 신뢰할 근거가 됩니다.

    단, 서버가 RSA나 ECDSA 등 다른 알고리즘의 호스트 키를 제시했다면 실제 제시된 키와 동일한 알고리즘의 공개 키 지문을 비교해야 합니다.

    SSH 연결 자체가 의심되는 상황에서 해당 SSH 연결을 통해서만 새 키를 확인하는 것은 독립적인 신원 검증이 아닙니다. 가능하면 클라우드 콘솔이나 신뢰할 수 있는 서버 관리자 등 별도의 경로를 사용해야 합니다.

    5. ssh-keygen -R로 잘못된 호스트 키 항목 수정하기

    서버가 정상적으로 재설치되었거나 호스트 키가 정당하게 변경된 사실을 확인했다면 기존에 저장된 키 항목을 제거할 수 있습니다.

    먼저 필요하다면 known_hosts 파일을 백업합니다.

    cp ~/.ssh/known_hosts ~/.ssh/known_hosts.bak

    그다음 해당 서버의 기존 항목만 제거합니다.

    ssh-keygen -R 192.0.2.10

    비표준 포트를 사용하는 경우에는 다음과 같이 지정합니다.

    ssh-keygen -R '[192.0.2.10]:2222'

    이 명령어는 지정한 호스트에 해당하는 항목을 known_hosts 파일에서 제거하는 데 사용됩니다.

    도메인 이름과 IP 주소를 각각 사용해 접속한 적이 있다면 두 이름에 대한 저장 항목을 별도로 확인해야 할 수 있습니다.

    ssh-keygen -F server.example.com
    ssh-keygen -F 192.0.2.10

    중요한 것은 파일 전체를 삭제하지 않고 문제가 확인된 호스트의 항목만 정리하는 것입니다.

    6. SSH 재접속 시 새 호스트 키 등록하기

    기존 키 항목을 정리한 뒤에는 SSH 연결을 다시 시도합니다.

    ssh user@192.0.2.10

    처음 접속하는 서버로 인식되면 다음과 같은 확인 메시지가 나타날 수 있습니다.

    The authenticity of host '192.0.2.10' can't be established.
    ED25519 key fingerprint is SHA256:EXAMPLE_FINGERPRINT_NOT_A_REAL_KEY
    
    Are you sure you want to continue connecting (yes/no/[fingerprint])?

    여기에서 바로 yes를 입력하는 것이 아니라 앞서 신뢰할 수 있는 경로에서 확인한 서버의 호스트 키 지문과 화면에 표시된 지문이 일치하는지 비교해야 합니다.

    지문이 일치하고 접속 대상이 올바르다는 사실을 확인했다면 새 키를 등록하고 접속을 계속할 수 있습니다.

    반대로 지문이 일치하지 않는다면 연결을 중단하고 DNS, IP 주소, 서버 교체 여부, 네트워크 경로를 다시 확인해야 합니다.

    7. StrictHostKeyChecking=no를 사용해도 될까?

    SSH 호스트 키 오류를 검색하면 다음과 같은 명령어를 해결 방법으로 소개하는 경우가 있습니다.

    ssh -o StrictHostKeyChecking=no user@192.0.2.10

    하지만 StrictHostKeyChecking=no는 일부 호스트 키 확인 동작을 완화하는 옵션이며, 기존 호스트 키가 변경된 상황에서도 연결을 무조건 안전하게 만들어주지는 않습니다. OpenSSH 버전과 설정에 따라 연결 제한이나 경고가 남을 수 있습니다.

    또한 다음과 같이 호스트 키 저장을 사실상 무력화하는 방식도 운영 서버에서는 피하는 것이 좋습니다.

    ssh -o UserKnownHostsFile=/dev/null \
        -o StrictHostKeyChecking=no \
        user@192.0.2.10

    이런 설정은 서버 신원 확인을 약화시켜 잘못된 서버에 연결하거나 중간자 공격을 감지하지 못할 위험을 높입니다.

    호스트 키 오류를 해결하기 위해 보안 검증 기능을 끄는 것보다 실제 서버의 키를 확인하고 known_hosts 항목을 올바르게 갱신하는 것이 권장되는 방법입니다.

    8. known_hosts를 수정했는데 오류가 계속 발생하는 경우

    기존 항목을 제거했는데도 같은 오류가 반복된다면 SSH 클라이언트가 다른 설정 파일이나 호스트 이름을 사용하고 있을 가능성을 확인해야 합니다.

    먼저 SSH 상세 로그를 확인합니다.

    ssh -vvv user@192.0.2.10

    현재 적용되는 SSH 설정을 확인하려면 다음 명령어도 사용할 수 있습니다.

    ssh -G 192.0.2.10

    특히 userknownhostsfile, globalknownhostsfile, hostname, port, hostkeyalias 등의 설정을 확인합니다.

    환경에 따라 사용자별 known_hosts 외에 시스템 전역의 호스트 키 파일이 사용될 수도 있습니다.

    또한 DNS가 변경됐거나 로드밸런서 뒤의 여러 서버가 서로 다른 호스트 키를 제시한다면 연결할 때마다 키가 달라지는 현상이 발생할 수 있습니다. 이 경우 단순히 키를 반복 삭제하기보다 서버 구성과 접속 경로를 확인해야 합니다.

    실전 해결 순서

    SSH 접속 시 Host Key Verification Failed 오류가 발생했다면 다음 순서로 확인하는 것이 좋습니다.

    # 1. 상세 오류 메시지 확인
    ssh -vvv user@192.0.2.10
    
    # 2. 기존에 저장된 서버 키 검색
    ssh-keygen -F 192.0.2.10
    
    # 3. 서버 콘솔에서 실제 키 지문 확인
    sudo ssh-keygen -lf /etc/ssh/ssh_host_ed25519_key.pub
    
    # 4. 서버 신원 검증 후 기존 항목 백업
    cp ~/.ssh/known_hosts ~/.ssh/known_hosts.bak
    
    # 5. 확인된 기존 호스트 키 항목 제거
    ssh-keygen -R 192.0.2.10
    
    # 6. SSH 재접속 및 지문 비교
    ssh user@192.0.2.10

    3단계는 SSH 클라이언트가 아니라 신뢰할 수 있는 별도의 경로로 접근한 실제 서버에서 실행하는 명령어입니다. 서버 지문을 검증하지 못했다면 5~6단계로 바로 진행하지 않는 것이 안전합니다.

    정리

    SSH 접속 시 Host Key Verification Failed 오류가 발생했다면 비밀번호나 SSH 포트 문제를 먼저 의심하기보다 서버의 호스트 키 검증 과정에서 무엇이 달라졌는지 확인해야 합니다.

    서버 재설치나 인스턴스 교체처럼 정당한 변경이 있었다면 새 호스트 키의 지문을 검증한 뒤 ssh-keygen -R로 기존 항목을 정리하고 다시 연결하면 됩니다.

    반대로 서버 변경 이력이 없는데 갑자기 호스트 키가 달라졌다면 known_hosts 파일을 바로 삭제하거나 StrictHostKeyChecking을 끄지 말고 서버 신원과 연결 경로부터 확인하는 것이 중요합니다.

    핵심은 오류 메시지 확인 → 기존 키 조회 → 새 키 지문 검증 → known_hosts 수정 → 안전한 재접속 순서를 지키는 것입니다.

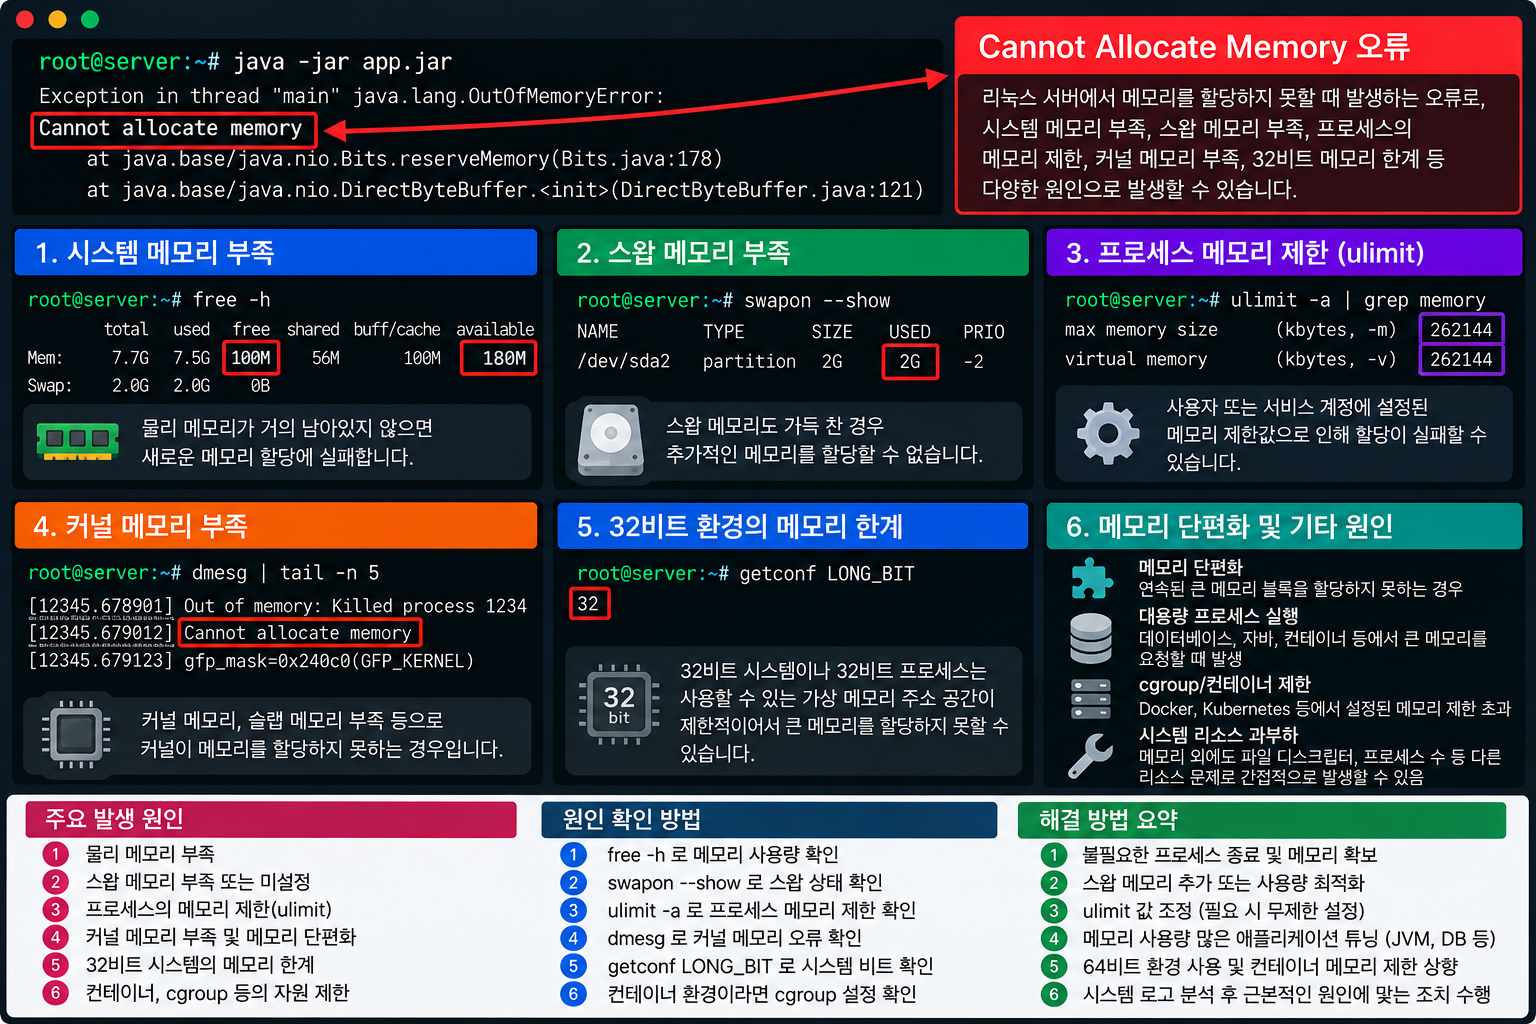
  • 리눅스 서버에서 Cannot Allocate Memory 오류가 발생하는 원인

    리눅스 서버에서 Cannot Allocate Memory 오류가 발생하는 원인

    리눅스 서버에서 프로그램을 실행하거나 새로운 프로세스를 생성하려는데 갑자기 Cannot allocate memory 오류가 발생하는 경우가 있습니다. SSH 접속은 정상적으로 되지만 명령어 실행이 실패하거나, Python·Java·MySQL 같은 애플리케이션이 시작되지 않는 현상도 나타날 수 있습니다.

    이런 오류가 발생하면 서버의 RAM이 모두 사용됐다고 생각하기 쉽습니다. 하지만 실제 물리 메모리가 부족한 경우뿐 아니라 Swap 부족, 프로세스의 가상 메모리 제한, 컨테이너 메모리 제한, 커널의 메모리 할당 정책 때문에도 문제가 발생할 수 있습니다.

    특히 free -h에서 사용 가능한 메모리가 남아 있는데도 fork: Cannot allocate memory가 발생한다면 단순히 RAM 사용량만 확인해서는 원인을 찾기 어렵습니다.

    이번 글에서는 메모리 상태 확인 → 프로세스별 사용량 분석 → OOM Killer 로그 점검 → Swap 및 시스템 제한 확인 → 원인별 해결 순서로 서버를 안전하게 점검하는 방법을 살펴봅니다.

    Cannot Allocate Memory 핵심 명령어 한눈에 보기

    오류가 발생했다면 먼저 아래 명령어로 시스템 메모리와 프로세스 상태를 확인합니다. 메모리가 심하게 부족한 서버에서는 새 명령어 실행 자체가 실패할 수 있으므로 가능하면 기존 SSH 세션이나 서버 콘솔을 유지한 상태에서 점검해야 합니다.

    점검 목적명령어
    RAM·Swap 사용량free -h
    메모리 상태 변화vmstat 1 5
    메모리 사용 상위 프로세스ps aux --sort=-rss | head -n 15
    OOM 관련 커널 로그sudo journalctl -k -b | grep -Ei 'out of memory|oom|killed process'
    메모리 커밋 상태grep -E 'CommitLimit|Committed_AS' /proc/meminfo
    프로세스 자원 제한ulimit -a
    Swap 장치 확인swapon --show

    가장 먼저 확인할 값은 단순한 free 메모리보다 실제로 새 작업에 사용할 수 있는 메모리를 추정하는 available 값입니다. 다만 available이 충분해 보여도 메모리 커밋 제한이나 cgroup 제한 등으로 할당에 실패할 수 있습니다.

    리눅스 Cannot Allocate Memory 오류와 free vmstat OOM 메모리 점검 방법
    Cannot Allocate Memory 오류 발생 시 RAM, Swap, 메모리 사용 프로세스와 OOM 로그를 확인하는 예시입니다.

    1. Cannot Allocate Memory 오류가 발생하는 이유

    리눅스에서 Cannot allocate memory는 일반적으로 ENOMEM 오류와 관련이 있습니다. 프로그램이 메모리 할당이나 프로세스 생성에 필요한 자원을 확보하지 못했을 때 나타날 수 있습니다.

    예를 들어 새로운 프로세스를 실행하려 할 때 다음과 같은 메시지가 표시될 수 있습니다.

    bash: fork: Cannot allocate memory

    또는 Python 프로그램에서 메모리 할당이 실패하면 다음과 같은 오류가 발생할 수 있습니다.

    MemoryError

    두 오류 모두 메모리 자원 문제와 관련될 수 있지만 발생 위치와 직접적인 원인은 다를 수 있습니다.

    대표적인 원인은 다음과 같습니다.

    • 물리 메모리 부족: 실행 중인 프로세스가 사용 가능한 RAM을 대부분 소비한 경우
    • Swap 부족: 메모리 압박 상황에서 추가적인 여유 공간이 부족한 경우
    • 메모리 커밋 제한: 커널의 overcommit 정책에 따라 새로운 메모리 예약이 거부된 경우
    • 프로세스 자원 제한: 주소 공간 크기 등 사용자 또는 프로세스별 제한에 도달한 경우
    • 컨테이너 제한: Docker나 Kubernetes의 메모리 제한에 도달한 경우
    • 커널 메모리 할당 문제: 특정 크기나 유형의 메모리 할당이 실패한 경우
    • 애플리케이션 메모리 증가: 메모리 누수나 과도한 캐시 사용으로 사용량이 계속 늘어난 경우

    따라서 메모리 부족 메시지가 나타났다고 해서 무조건 서버 RAM을 증설하거나 Swap부터 추가하는 것은 적절하지 않을 수 있습니다.

    2. free -h로 RAM과 Swap 사용량 확인하기

    가장 기본적인 점검은 free 명령어입니다.

    free -h

    다음은 설명을 위한 출력 예시입니다.

                   total   used   free  shared  buff/cache  available
    Mem:            7.7Gi  6.2Gi  210Mi   120Mi      1.3Gi      890Mi
    Swap:           2.0Gi  1.7Gi  350Mi

    여기서 중요한 항목은 다음과 같습니다.

    • total: 전체 메모리 크기
    • used: 사용 중인 메모리의 추정치
    • free: 현재 사용되지 않는 메모리
    • buff/cache: 버퍼와 파일 캐시 등으로 사용되는 메모리
    • available: 새로운 작업에 사용할 수 있는 메모리의 추정치

    리눅스는 남는 메모리를 파일 캐시 등에 활용하므로 free 값이 작다는 사실만으로 메모리가 부족하다고 판단하면 안 됩니다.

    또한 Swap 사용량이 높다는 이유만으로 현재 메모리 부족 상태라고 단정할 수도 없습니다. Swap에 오래전에 이동된 페이지가 남아 있을 수 있기 때문입니다.

    실제 메모리 압박 여부는 available 값과 함께 Swap 입출력, 프로세스 사용량, OOM 로그를 비교해야 합니다.

    3. vmstat로 메모리 부족과 Swap 활동 확인하기

    메모리 부족이 일시적인지 지속적인지 확인하려면 vmstat 명령어를 사용할 수 있습니다.

    vmstat 1 5

    이 명령어는 1초 간격으로 시스템 상태를 5회 출력합니다.

    메모리 관련 항목에서는 swpd, free, si, so 값을 확인합니다.

    • swpd: 사용 중인 가상 메모리의 Swap 양
    • si: Swap에서 메모리로 읽어 들이는 양
    • so: 메모리에서 Swap으로 내보내는 양
    • free: 사용하지 않는 메모리 양

    si와 so 값이 반복적으로 높게 나타나고 서버 응답 속도도 느려진다면 메모리 압박으로 인해 Swap 입출력이 활발하게 발생하는 상황일 수 있습니다.

    단, vmstat의 첫 번째 출력 행은 일반적으로 부팅 이후의 평균 통계를 포함하므로 실시간 상태를 분석할 때는 이후 출력 행도 함께 확인해야 합니다.

    4. 메모리를 많이 사용하는 프로세스 찾기

    메모리 사용량이 비정상적으로 높다면 어떤 프로세스가 메모리를 소비하고 있는지 확인해야 합니다.

    ps aux --sort=-rss | head -n 15

    위 명령어는 RSS 기준으로 메모리 사용량이 큰 프로세스를 확인하는 데 사용할 수 있습니다.

    주요 항목은 다음과 같습니다.

    • PID: 프로세스 식별 번호
    • %MEM: 물리 메모리 대비 사용 비율
    • VSZ: 프로세스의 가상 주소 공간 크기
    • RSS: 실제 메모리에 상주하는 메모리 크기
    • COMMAND: 실행 중인 프로그램

    특히 특정 프로세스의 RSS가 계속 증가한다면 애플리케이션의 메모리 누수나 캐시 정책을 점검할 필요가 있습니다.

    다만 RSS에는 공유 메모리도 포함될 수 있으므로 여러 프로세스의 RSS를 단순 합산하면 실제 물리 메모리 사용량과 차이가 날 수 있습니다.

    원인이 확인되지 않은 상태에서 메모리 사용량이 높다는 이유만으로 프로세스를 강제 종료하면 데이터 손실이나 서비스 장애가 발생할 수 있습니다.

    5. OOM Killer 로그 확인하기

    리눅스 커널은 메모리 부족 상황에서 시스템을 보호하기 위해 OOM Killer를 통해 프로세스를 종료할 수 있습니다.

    최근 부팅 이후의 커널 로그에서 관련 메시지를 검색합니다.

    sudo journalctl -k -b | grep -Ei 'out of memory|oom|killed process'

    OOM이 발생한 경우 다음과 비슷한 메시지가 기록될 수 있습니다.

    Out of memory: Killed process 2481 (java)
    total-vm:4194304kB, anon-rss:2097152kB

    위 예시는 커널이 메모리 부족 상황에서 Java 프로세스를 종료한 경우를 나타냅니다.

    다만 Cannot Allocate Memory 오류가 발생했다고 해서 반드시 OOM Killer가 실행되는 것은 아닙니다. 메모리 할당이 거부되더라도 프로세스 종료 없이 오류만 반환될 수 있습니다.

    또한 OOM 로그가 없다고 해서 메모리 부족 문제가 없었다고 단정할 수 없습니다. 로그 보존 상태와 커널 설정, 컨테이너 환경에 따라 확인 가능한 정보가 달라질 수 있습니다.

    6. RAM이 남아 있는데 Cannot Allocate Memory가 발생하는 이유

    free -h에서 available 메모리가 충분해 보여도 새로운 메모리 할당이 실패할 수 있습니다.

    대표적으로 커널의 메모리 커밋 정책을 확인해야 하는 경우가 있습니다.

    cat /proc/sys/vm/overcommit_memory

    이 값은 커널이 메모리 할당 요청을 어떻게 판단할지 결정하는 설정입니다.

    • 0: 커널의 휴리스틱에 따라 메모리 커밋을 판단
    • 1: 메모리 커밋을 폭넓게 허용
    • 2: 설정된 커밋 한도에 따라 엄격하게 제한

    현재 커밋 상태는 다음 명령어로 확인합니다.

    grep -E 'CommitLimit|Committed_AS' /proc/meminfo

    Committed_AS가 CommitLimit에 가까운 상황에서 엄격한 overcommit 정책이 적용되고 있다면 새로운 메모리 예약이 거부될 수 있습니다.

    다만 문제를 해결하기 위해 vm.overcommit_memory=1로 무조건 변경하는 것은 권장하지 않습니다. 실제 메모리 부족 위험이 사라지는 것이 아니라 메모리 할당 실패 시점과 시스템 동작이 달라질 수 있기 때문입니다.

    7. ulimit과 프로세스별 메모리 제한 확인하기

    특정 사용자나 프로그램에서만 오류가 발생한다면 프로세스별 자원 제한을 확인할 필요가 있습니다.

    ulimit -a

    특히 다음 항목을 확인합니다.

    • virtual memory: 프로세스의 가상 주소 공간 크기 제한
    • data seg size: 데이터 세그먼트 크기 제한
    • max user processes: 사용자에게 적용되는 프로세스 수 제한

    프로세스 수 제한에 도달하면 일반적으로 Resource temporarily unavailable와 같은 다른 오류가 발생할 수 있으므로 메모리 할당 실패와 구분해야 합니다.

    또한 systemd로 실행하는 서비스에는 셸의 ulimit과 별도로 자원 제한이 적용될 수 있습니다.

    systemctl show myservice.service -p MemoryMax -p LimitAS -p LimitDATA

    위 명령어의 myservice.service는 실제 서비스 이름으로 변경해야 합니다.

    특정 서비스에서만 문제가 발생한다면 시스템 전체 메모리와 서비스별 제한을 함께 확인하는 것이 중요합니다.

    8. Docker 컨테이너에서 메모리 부족이 발생하는 경우

    Docker 컨테이너는 호스트 서버에 RAM이 충분히 남아 있어도 컨테이너에 설정된 메모리 제한에 도달할 수 있습니다.

    실시간 컨테이너 메모리 사용량을 확인합니다.

    docker stats --no-stream

    특정 컨테이너의 메모리 제한과 OOM 종료 여부를 확인하려면 다음 명령어를 사용할 수 있습니다.

    docker inspect mycontainer \
      --format 'Memory={{.HostConfig.Memory}} OOMKilled={{.State.OOMKilled}}'

    Memory 값은 바이트 단위이며, 0이면 Docker의 해당 메모리 제한이 설정되지 않았다는 의미입니다.

    OOMKilled가 true라면 컨테이너가 OOM 상황으로 종료됐음을 나타낼 수 있습니다. 다만 현재 상태와 종료 이력에 따라 추가 로그 확인이 필요할 수 있습니다.

    컨테이너의 메모리 제한을 높이기 전에 애플리케이션이 정상적으로 메모리를 사용하는지, 메모리 누수가 있는지 먼저 확인해야 합니다.

    9. Swap 추가가 필요한 상황과 주의할 점

    서버에 Swap이 없거나 메모리 압박이 반복된다면 Swap 구성을 검토할 수 있습니다.

    swapon --show
    free -h

    Swap은 메모리 부족 상황에서 일부 페이지를 디스크로 이동할 수 있도록 지원하지만 RAM을 대체하는 고속 메모리는 아닙니다.

    특히 디스크가 느리거나 메모리 부족이 지속되는 서버에서는 Swap 사용량 증가로 응답 지연이 심해질 수 있습니다.

    또한 Swap을 추가한다고 해서 프로세스의 주소 공간 제한, 컨테이너 메모리 제한, 특정 메모리 할당 실패가 모두 해결되는 것은 아닙니다.

    따라서 실제 메모리 압박이 확인됐을 때 워크로드와 저장장치 성능을 고려해 Swap 크기를 결정해야 합니다.

    실전 점검 순서

    리눅스 서버에서 Cannot Allocate Memory 오류가 반복된다면 다음 순서로 원인을 좁힐 수 있습니다.

    # 1. 전체 RAM과 Swap 확인
    free -h
    
    # 2. 메모리와 Swap 활동 확인
    vmstat 1 5
    
    # 3. 메모리 사용량이 큰 프로세스 확인
    ps aux --sort=-rss | head -n 15
    
    # 4. OOM Killer 로그 검색
    sudo journalctl -k -b | grep -Ei 'out of memory|oom|killed process'
    
    # 5. Swap 장치 확인
    swapon --show
    
    # 6. 메모리 커밋 정책 확인
    cat /proc/sys/vm/overcommit_memory
    
    # 7. 커밋 사용량 확인
    grep -E 'CommitLimit|Committed_AS' /proc/meminfo
    
    # 8. 현재 셸의 자원 제한 확인
    ulimit -a

    Docker나 systemd 서비스에서만 문제가 발생한다면 해당 컨테이너 또는 서비스에 적용된 메모리 제한도 추가로 확인합니다.

    메모리 사용량이 높은 프로세스를 발견했다면 서비스의 정상적인 사용 패턴인지, 특정 요청 이후 급격히 증가하는지, 재시작 이후에도 반복되는지 비교해야 합니다.

    운영 서버에서는 원인을 확인하기 전에 캐시를 강제로 비우거나 프로세스를 무작정 종료하는 방법을 우선 사용하지 않는 것이 좋습니다.

    정리

    리눅스 서버에서 Cannot Allocate Memory 오류가 발생하는 이유는 단순한 RAM 부족만이 아닙니다. Swap 부족, 메모리 커밋 정책, 프로세스별 자원 제한, Docker 메모리 제한 등 여러 요인이 영향을 줄 수 있습니다.

    먼저 free -h로 전체 메모리를 확인하고, vmstat로 메모리 압박을 점검한 뒤, 프로세스 사용량과 OOM 로그를 함께 분석하는 것이 좋습니다.

    특히 사용 가능한 RAM이 남아 있는데도 오류가 발생한다면 메모리 커밋 제한과 서비스·컨테이너별 메모리 제한을 확인해야 합니다.

    핵심 점검 순서는 RAM·Swap 확인 → 메모리 사용 프로세스 분석 → OOM 로그 점검 → 시스템 제한 확인 → 원인에 맞는 설정 변경입니다.

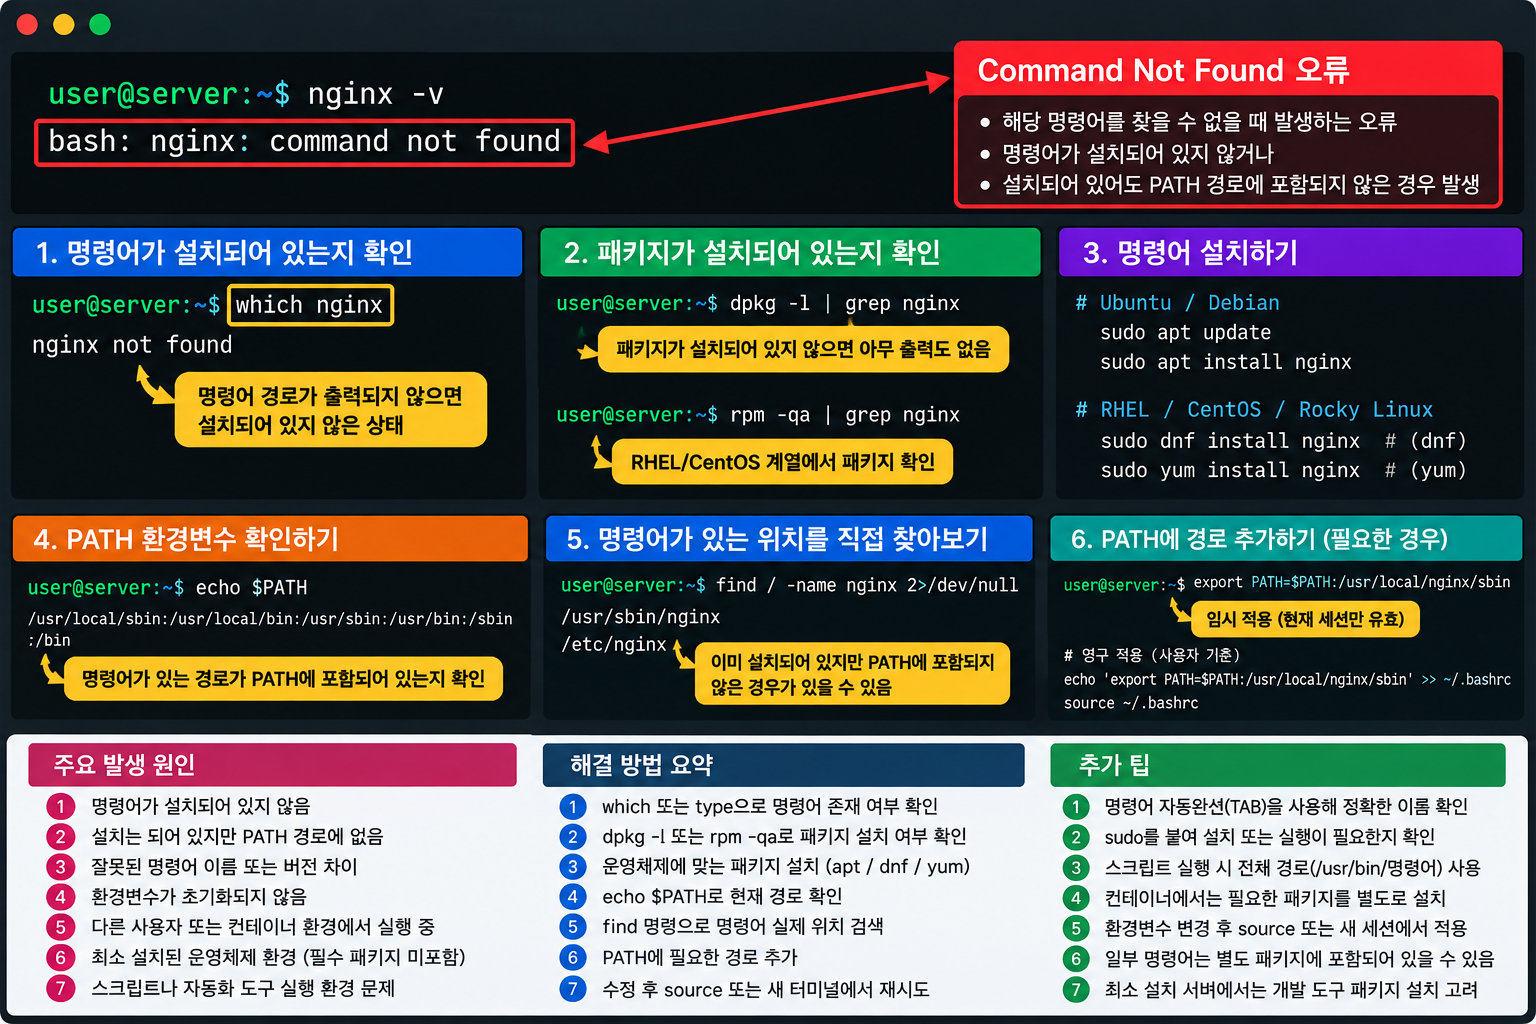
  • 리눅스 서버에서 Command Not Found 오류가 발생할 때 해결 방법

    리눅스 서버에서 Command Not Found 오류가 발생할 때 해결 방법

    리눅스 서버에 SSH로 접속해 평소 사용하던 명령어를 실행했는데 갑자기 Command Not Found 오류가 나타난 경험이 있으신가요? 특히 Python이나 Node.js를 설치한 직후, 서버를 재부팅한 뒤, 또는 일반 사용자에서는 실행되던 명령어가 sudo나 Cron 환경에서 실행되지 않을 때 이런 문제가 발생할 수 있습니다.

    명령어를 분명 설치했는데도 bash: command not found라는 메시지가 나오면 프로그램이 제대로 설치되지 않았다고 생각하기 쉽습니다. 하지만 실제로는 PATH 환경변수에 실행 파일 경로가 등록되지 않았거나, 현재 셸과 실행 환경이 달라 명령어를 찾지 못하는 경우도 많습니다.

    이때 프로그램을 무작정 다시 설치하거나 인터넷에서 찾은 PATH 설정을 그대로 복사하면 기존 환경변수를 덮어쓰거나 잘못된 실행 파일을 사용하게 될 수 있습니다. 따라서 먼저 명령어가 실제로 존재하는지, 현재 셸이 어떤 경로에서 실행 파일을 찾는지 구분해서 확인하는 것이 중요합니다.

    이번 글에서는 command -v, type, echo $PATH, find 등의 명령어로 오류 원인을 추적하고, 패키지 설치, PATH 수정, 실행 권한, sudo·Cron 환경 차이, 셸 설정 문제까지 실제 서버 점검 순서대로 해결하는 방법을 살펴봅니다.

    Command Not Found 핵심 명령어 한눈에 보기

    명령어가 실행되지 않는다면 먼저 아래 점검 명령어를 사용하세요. 예제에서는 node 명령어를 기준으로 설명합니다.

    점검 목적 명령어
    명령어 검색 command -v node
    명령어 종류 확인 type -a node
    PATH 확인 printf '%s\n' "$PATH"
    실행 파일 검색 find /usr/local /opt -type f -name node 2>/dev/null
    실행 권한 확인 ls -l /usr/local/bin/node
    sudo 환경 PATH 확인 sudo env | grep '^PATH='

    command -v로 명령어를 찾지 못한다고 해서 프로그램이 반드시 설치되지 않은 것은 아닙니다. 설치된 실행 파일이 PATH에 포함되지 않았거나 현재 셸 환경에서 접근할 수 없는 상태일 수도 있습니다.

    리눅스 Command Not Found 오류와 PATH 환경변수 점검 화면
    Command Not Found 오류 발생 시 command -v와 PATH 환경변수를 확인해 명령어를 찾지 못하는 원인을 점검하는 예시입니다.

    1. Command Not Found 오류가 발생하는 대표적인 원인

    리눅스에서 명령어를 입력하면 셸은 내장 명령어, 함수, 별칭 및 PATH에 등록된 경로 등을 확인해 실행할 대상을 찾습니다.

    이 과정에서 실행할 명령어를 찾지 못하면 셸에 따라 다음과 같은 오류가 표시될 수 있습니다.

    $ node --version
    bash: node: command not found

    대표적인 원인은 다음과 같습니다.

    • 패키지 미설치: 실행하려는 프로그램이 서버에 설치되지 않은 경우
    • PATH 누락: 실행 파일이 있지만 PATH에 해당 디렉터리가 없는 경우
    • 명령어 오타: 대소문자나 명령어 이름을 잘못 입력한 경우
    • 사용자 환경 차이: SSH 사용자와 root 계정의 PATH가 다른 경우
    • 셸 설정 문제: .bashrc, .profile 등의 환경변수 설정이 잘못된 경우
    • 가상환경 문제: Python venv 또는 Node.js 버전 관리 환경이 활성화되지 않은 경우
    • 자동 실행 환경: Cron, systemd 등에서 PATH가 다르게 적용되는 경우

    따라서 Command Not Found 오류는 단순히 패키지를 설치하는 것만으로 해결되지 않을 수 있습니다.

    2. command -v와 type으로 명령어 설치 여부 확인하기

    가장 먼저 확인할 것은 현재 셸이 해당 명령어를 찾을 수 있는지입니다.

    command -v node

    정상적으로 찾을 수 있다면 다음과 같은 경로가 표시될 수 있습니다.

    /usr/bin/node

    아무 결과도 나타나지 않는다면 현재 환경에서 해당 명령어를 찾지 못하고 있다는 의미입니다.

    명령어가 별칭인지, 셸 함수인지, 실행 파일인지까지 확인하려면 다음 명령어를 사용합니다.

    type -a node

    예를 들어 다음과 같은 결과가 나타날 수 있습니다.

    node is /usr/local/bin/node
    node is /usr/bin/node

    이 경우 같은 이름의 실행 파일이 여러 위치에 존재한다는 것을 알 수 있습니다. 실제 실행되는 파일은 PATH 검색 순서와 셸 상태에 영향을 받습니다.

    여러 버전의 Python이나 Node.js를 설치한 서버에서는 어떤 경로의 실행 파일이 우선 사용되는지 확인하는 것이 특히 중요합니다.

    3. PATH 환경변수가 잘못됐는지 확인하기

    명령어가 설치되어 있는데도 실행되지 않는다면 PATH 환경변수를 확인해야 합니다.

    echo "$PATH"

    일반적으로 다음과 같은 결과가 표시됩니다.

    /usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/sbin:/bin

    PATH는 셸이 실행 파일을 검색하는 디렉터리 목록입니다. 각 경로는 콜론(:)으로 구분됩니다.

    예를 들어 프로그램이 /opt/myapp/bin에 설치되어 있는데 해당 경로가 PATH에 없다면 명령어 이름만으로는 실행되지 않을 수 있습니다.

    먼저 절대경로로 실행할 수 있는지 확인합니다.

    /opt/myapp/bin/mytool --version

    절대경로에서는 실행되지만 mytool만 입력하면 실패한다면 PATH 문제일 가능성이 높습니다.

    현재 셸에서 임시로 경로를 추가하려면 다음과 같이 사용합니다.

    export PATH="$PATH:/opt/myapp/bin"

    다시 명령어를 확인합니다.

    command -v mytool
    mytool --version

    이 설정은 현재 셸 세션에 적용됩니다. 새로운 로그인에서도 사용하려면 실제 셸 종류와 로그인 방식에 맞는 환경 설정 파일에 추가해야 합니다.

    PATH를 수정할 때 기존 값을 제거하고 새 경로만 지정하면 ls, cp 같은 기본 명령어까지 찾지 못하는 문제가 발생할 수 있으므로 주의해야 합니다.

    4. 프로그램이 설치되지 않았다면 패키지 관리자 확인하기

    실행 파일을 찾을 수 없다면 패키지가 실제로 설치되어 있는지 확인합니다.

    Ubuntu 또는 Debian 계열에서는 설치된 패키지를 다음과 같이 조회할 수 있습니다.

    dpkg -l | grep -i curl

    설치되지 않은 것이 확인됐고 해당 프로그램이 필요한 상황이라면 패키지 관리자를 통해 설치할 수 있습니다.

    sudo apt update
    sudo apt install curl

    RHEL, Rocky Linux, AlmaLinux 등 DNF 기반 환경에서는 다음과 같은 방법을 사용할 수 있습니다.

    sudo dnf install curl

    다만 모든 프로그램이 배포판 기본 저장소에 존재하는 것은 아닙니다. Node.js, Python 또는 특정 개발 도구는 별도 저장소나 버전 관리 도구로 설치됐을 수 있으므로 기존 설치 방식을 먼저 확인하는 것이 좋습니다.

    5. 실행 파일은 있는데 명령어가 실행되지 않는 경우

    파일이 존재한다면 먼저 실행 권한과 파일 유형을 확인합니다.

    ls -l /opt/myapp/bin/mytool
    file /opt/myapp/bin/mytool

    실행 권한이 없다면 일반적으로 Command Not Found보다는 Permission denied 같은 오류가 발생할 수 있습니다.

    스크립트 파일의 경우 첫 줄에 지정된 인터프리터가 존재하지 않거나 줄바꿈 형식이 잘못되어도 실행이 실패할 수 있습니다.

    head -n 1 /opt/myapp/bin/mytool

    예를 들어 스크립트가 존재하지 않는 인터프리터를 참조한다면 파일 자체는 있어도 실행 과정에서 오류가 발생합니다.

    또한 현재 디렉터리에 있는 실행 파일은 현재 디렉터리가 PATH에 포함되지 않았다면 이름만으로 실행되지 않을 수 있습니다.

    ./script.sh

    이때는 실행 권한이 있어야 하며, 권한이 없다면 파일 소유자와 실행 목적을 확인한 뒤 필요한 권한만 부여해야 합니다.

    6. sudo에서는 명령어가 실행되지 않는 이유

    일반 사용자 계정에서는 정상적으로 실행되던 명령어가 sudo를 붙이면 찾을 수 없다는 오류를 표시하는 경우도 있습니다.

    $ mytool --version
    mytool 1.0
    
    $ sudo mytool --version
    sudo: mytool: command not found

    이는 일반 사용자와 sudo 실행 환경의 PATH가 다르기 때문일 수 있습니다. 일부 시스템에서는 sudoers의 secure_path 설정이 명령어 검색 경로에 영향을 줍니다.

    먼저 일반 사용자와 sudo 환경의 PATH를 비교합니다.

    echo "$PATH"
    sudo env | grep '^PATH='

    실행 파일의 실제 위치도 확인합니다.

    command -v mytool

    필요하다면 신뢰할 수 있는 실행 파일의 절대경로를 지정해 실행할 수 있습니다.

    sudo /opt/myapp/bin/mytool --version

    다만 사용자별로 설치된 개발 도구를 root 권한으로 실행하면 파일 소유권이나 환경 설정이 달라질 수 있으므로 해당 프로그램에 관리자 권한이 실제로 필요한지 먼저 판단해야 합니다.

    7. SSH에서는 되는데 Cron과 systemd에서는 실패하는 경우

    SSH로 직접 로그인하면 정상적으로 실행되는 명령어가 Cron이나 systemd 서비스에서만 실패하는 경우가 있습니다.

    이는 자동 실행 환경이 사용자의 로그인 셸과 동일한 환경변수를 불러오지 않을 수 있기 때문입니다.

    Cron 작업에서는 실행 파일의 절대경로를 사용하는 것이 좋습니다.

    /usr/bin/python3 /opt/scripts/backup.py

    필요하다면 Crontab에 명시적으로 PATH를 지정할 수도 있습니다.

    PATH=/usr/local/bin:/usr/bin:/bin
    
    0 2 * * * /usr/bin/python3 /opt/scripts/backup.py

    systemd 서비스라면 서비스 유닛의 ExecStart에 실행 파일의 절대경로를 지정하는 방식이 명확합니다.

    ExecStart=/usr/bin/python3 /opt/scripts/backup.py

    특히 Python 가상환경이나 Node.js 버전 관리 도구를 사용하는 경우 일반 셸에서만 설정되는 경로에 의존하지 않도록 구성해야 합니다.

    8. .bashrc와 .profile 수정 후 명령어가 사라졌다면

    환경변수 설정을 수정한 직후 기본 명령어까지 실행되지 않는다면 PATH가 잘못 덮어써졌는지 확인해야 합니다.

    예를 들어 다음 설정은 기존 PATH를 제거합니다.

    export PATH="/opt/myapp/bin"

    이 경우 기본 명령어 디렉터리가 PATH에서 빠질 수 있습니다.

    기존 경로를 유지하면서 추가하려면 다음처럼 작성합니다.

    export PATH="$PATH:/opt/myapp/bin"

    이미 PATH가 잘못 설정됐다면 현재 셸에서 임시로 기본 경로를 복구할 수 있습니다.

    export PATH="/usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/sbin:/bin"

    그다음 실제로 잘못 수정한 .bashrc, .profile 등 환경 설정 파일을 확인하고 수정해야 합니다.

    환경 설정 파일을 수정한 뒤에는 새 셸에서 테스트하는 것이 좋으며, 현재 SSH 세션을 바로 종료하지 않는 편이 안전합니다.

    실전 점검 순서

    예를 들어 서버에서 node 명령어가 실행되지 않는다면 다음 순서대로 확인할 수 있습니다.

    # 1. 명령어 존재 여부 확인
    command -v node
    
    # 2. 명령어 종류와 경로 확인
    type -a node
    
    # 3. PATH 환경변수 확인
    echo "$PATH"
    
    # 4. 설치 경로 검색
    find /usr/local /opt -type f -name node 2>/dev/null
    
    # 5. 실제 파일이 있다면 권한 확인
    ls -l /usr/local/bin/node
    
    # 6. 절대경로로 실행 테스트
    /usr/local/bin/node --version
    
    # 7. PATH에 경로가 없다면 임시 추가
    export PATH="$PATH:/usr/local/bin"
    
    # 8. 다시 명령어 확인
    command -v node
    node --version

    위 경로는 예시입니다. 실제 실행 파일의 위치는 배포판과 설치 방법에 따라 달라질 수 있습니다.

    또한 command -v 결과가 비어 있어도 실행 파일이 다른 위치에 존재할 수 있으므로 바로 재설치하기보다 PATH와 설치 경로를 함께 확인하는 것이 좋습니다.

    정리

    리눅스 서버에서 Command Not Found 오류가 발생했다면 프로그램이 설치되지 않았다고 단정하기보다 명령어 검색 경로, 실행 파일 존재 여부, 사용자 환경 차이부터 확인해야 합니다.

    가장 먼저 기억할 명령어는 다음 세 가지입니다.

    command -v 명령어
    type -a 명령어
    echo "$PATH"

    명령어가 설치되어 있다면 절대경로로 실행되는지 확인하고, PATH가 잘못됐다면 기존 경로를 유지하면서 필요한 디렉터리만 추가합니다.

    특히 SSH에서는 정상 실행되는데 sudo, Cron, systemd에서만 실패한다면 각 실행 환경의 PATH와 설정을 비교해야 합니다. 명령어 재설치보다 현재 환경에서 실행 파일을 어떻게 찾고 있는지 확인하는 것이 문제를 빠르게 해결하는 핵심입니다.

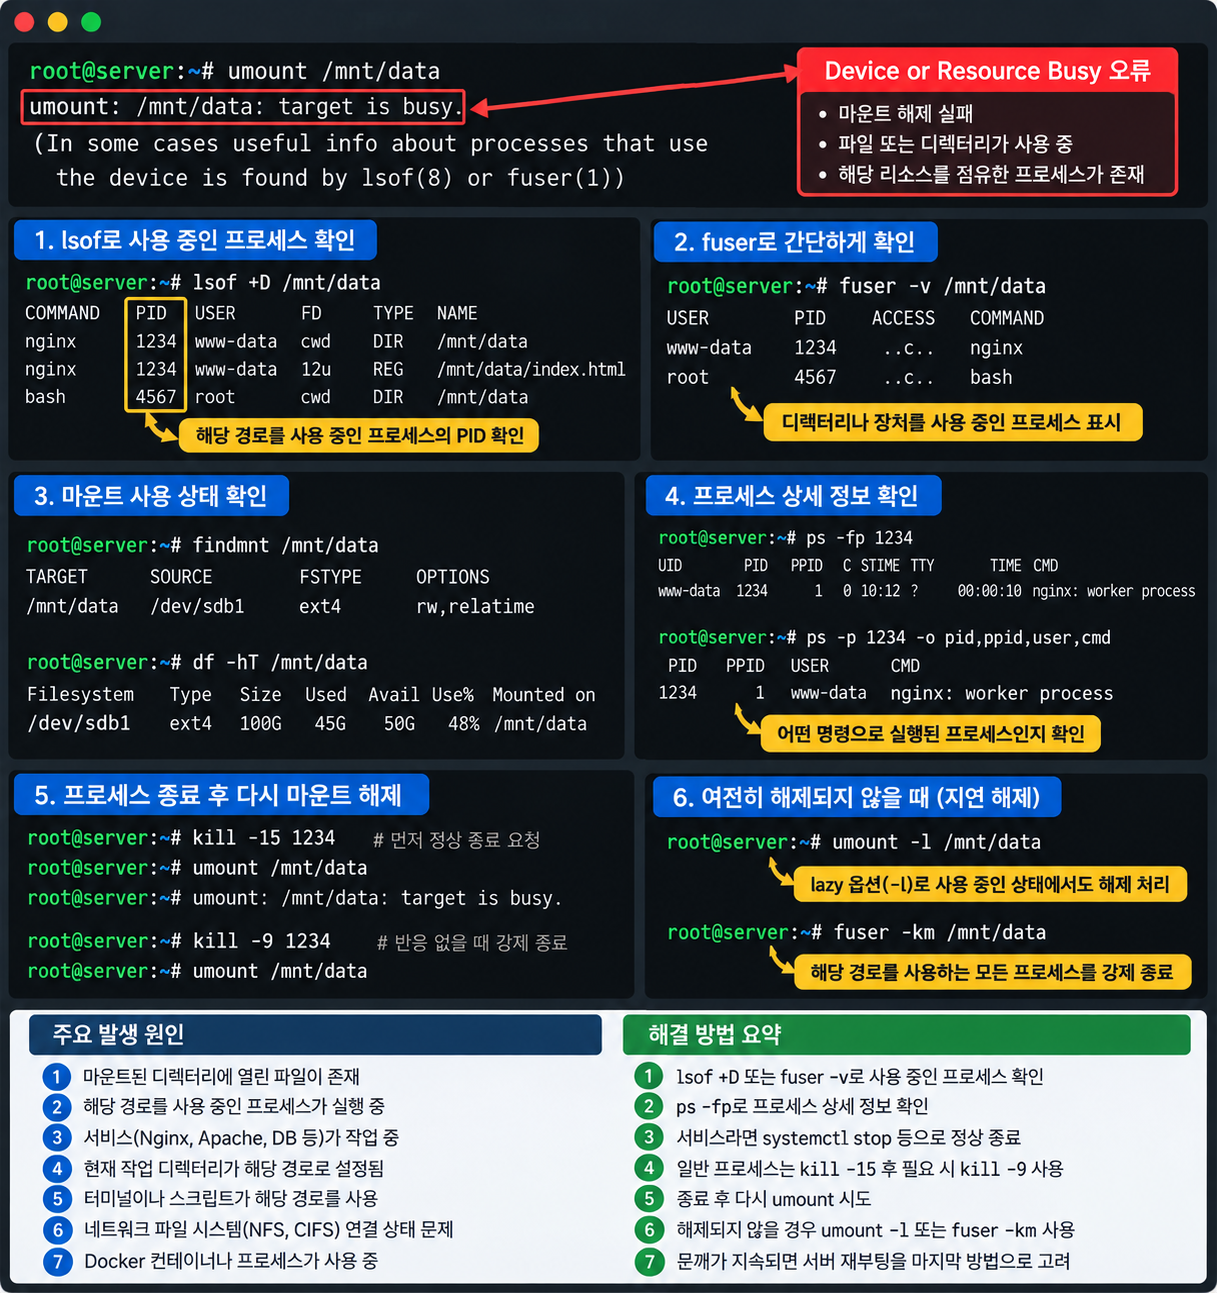
  • 리눅스 서버에서 Device or Resource Busy 오류가 발생하는 원인과 해결 방법

    리눅스 서버에서 Device or Resource Busy 오류가 발생하는 원인과 해결 방법

    리눅스 서버에서 디렉터리를 삭제하거나 디스크를 마운트 해제하려고 할 때 Device or Resource Busy 오류가 발생해 작업이 중단된 경험이 있으신가요? 특히 백업 작업이 끝난 뒤 외장 디스크를 분리하거나, Docker 컨테이너를 정리하고 디렉터리를 삭제하는 과정에서 이런 오류가 나타날 수 있습니다.

    분명 사용 중인 프로그램이 없어 보이는데도 umount나 rm 명령이 실패하면 파일 권한이나 디스크 자체의 문제부터 의심하기 쉽습니다. 하지만 실제로는 다른 프로세스가 해당 경로를 열어두었거나, 현재 작업 디렉터리로 사용하거나, 하위 마운트가 남아 있는 경우가 많습니다.

    이럴 때 무작정 kill -9으로 프로세스를 종료하거나 강제 마운트 해제를 시도하면 운영 중인 서비스와 데이터에 영향을 줄 수 있습니다. 따라서 먼저 어떤 자원이 사용 중인지 확인하고, 점유 원인에 맞는 방법으로 안전하게 해제해야 합니다.

    이번 글에서는 Device or Resource Busy 오류가 발생하는 대표적인 상황을 구분하고, lsof, fuser, findmnt를 이용한 점검부터 프로세스 종료, 마운트 해제, Docker 환경 점검까지 실제 해결 순서대로 살펴봅니다.

    Device or Resource Busy 핵심 명령어 한눈에 보기

    오류가 발생한 경로가 /mnt/data라고 가정하면 다음 명령어부터 확인할 수 있습니다.

    점검 목적 명령어
    열린 파일 확인 sudo lsof +D /mnt/data
    마운트 사용 프로세스 sudo fuser -vm /mnt/data
    마운트 상태 확인 findmnt -R /mnt/data
    현재 작업 위치 확인 pwd
    프로세스 상세 정보 ps -fp PID

    lsof +D는 지정한 디렉터리 아래를 재귀적으로 탐색하므로 파일이 많은 경로에서는 실행 시간이 길어질 수 있습니다. 마운트 해제가 목적이라면 fuser -vm과 findmnt를 먼저 확인하는 편이 효율적입니다.

    Device or Resource Busy 오류 발생 후 fuser 명령어로 마운트 지점을 사용 중인 프로세스를 확인하는 예시입니다.

    1. Device or Resource Busy 오류가 발생하는 이유

    Device or Resource Busy는 리눅스에서 주로 EBUSY 오류에 해당합니다. 요청한 작업을 처리하려는 시점에 커널이 해당 자원을 사용 중이라고 판단해 작업을 거부하는 상황입니다.

    다만 같은 오류 메시지라도 실행한 명령어에 따라 원인은 달라집니다.

    • umount 실패: 열린 파일, 작업 디렉터리, 하위 마운트 등이 남아 있는 경우
    • rm 또는 rmdir 실패: 삭제 대상이 마운트 지점이거나 커널이 사용 중인 특수 경로인 경우
    • mv 실패: 마운트 지점이나 사용 중인 특수 자원을 이동하려는 경우
    • Docker 작업 실패: 컨테이너의 볼륨이나 Bind Mount가 남아 있는 경우
    • 네트워크 스토리지: NFS 등의 연결 상태나 마운트 참조가 정리되지 않은 경우

    중요한 점은 일반 파일이 다른 프로세스에서 열려 있다는 이유만으로 항상 rm이 실패하는 것은 아니라는 것입니다. 리눅스에서는 열린 일반 파일도 삭제할 수 있으며, 파일을 사용 중인 프로세스가 종료될 때까지 실제 저장 공간이 유지될 수 있습니다.

    따라서 어떤 명령에서 오류가 발생했는지 먼저 구분해야 불필요한 프로세스 종료나 권한 변경을 피할 수 있습니다.

    2. lsof와 fuser로 자원을 사용하는 프로세스 찾기

    마운트 지점이나 디렉터리를 사용 중인 프로세스를 찾으려면 lsof와 fuser를 사용할 수 있습니다.

    먼저 디렉터리 아래에 열린 파일이 있는지 확인합니다.

    sudo lsof +D /mnt/data

    다음은 출력 예시입니다.

    COMMAND  PID   USER  FD   TYPE  NAME
    bash     2451  root  cwd  DIR   /mnt/data
    python3  3180  app   5r   REG   /mnt/data/report.csv

    여기서 확인해야 할 부분은 COMMAND, PID, FD, NAME입니다.

    • bash / 2451 / cwd: Bash 프로세스가 해당 디렉터리를 현재 작업 위치로 사용
    • python3 / 3180 / 5r: Python 프로세스가 파일을 읽기 모드로 열어둔 상태

    마운트 지점을 기준으로 사용 중인 프로세스를 확인하려면 다음 명령어도 유용합니다.

    sudo fuser -vm /mnt/data

    출력 결과는 환경에 따라 다음과 비슷하게 나타납니다.

                         USER   PID ACCESS COMMAND
    /mnt/data:           root  2451 ..c.. bash
                         app   3180 f.... python3

    ACCESS에 표시되는 c는 현재 작업 디렉터리, f는 열린 파일과 관련된 사용 상태를 의미합니다.

    다만 lsof와 fuser 결과가 비어 있다고 해서 마운트가 완전히 해제 가능한 상태라고 단정할 수는 없습니다. 하위 마운트, 다른 마운트 네임스페이스, 커널 수준의 참조 등도 확인해야 합니다.

    3. 현재 작업 디렉터리와 하위 마운트 확인하기

    터미널에서 마운트 지점 안으로 이동한 상태라면 해당 셸 자체가 마운트 해제를 방해할 수 있습니다.

    예를 들어 다음과 같은 상황입니다.

    cd /mnt/data
    sudo umount /mnt/data

    이때 다음 오류가 발생할 수 있습니다.

    umount: /mnt/data: target is busy.

    먼저 현재 작업 디렉터리를 확인합니다.

    pwd

    현재 위치가 마운트 지점 내부라면 다른 디렉터리로 이동합니다.

    cd /
    sudo umount /mnt/data

    단, 다른 터미널이나 프로세스가 같은 마운트를 사용 중이라면 현재 셸만 이동해도 문제가 해결되지 않을 수 있습니다.

    또한 마운트 지점 아래에 다른 파일시스템이 연결되어 있다면 상위 마운트를 해제하기 전에 하위 마운트를 먼저 확인해야 합니다.

    findmnt -R /mnt/data

    예를 들어 다음과 같이 표시될 수 있습니다.

    TARGET            SOURCE      FSTYPE
    /mnt/data         /dev/sdb1   ext4
    /mnt/data/backup  /dev/sdc1   ext4

    이 경우 /mnt/data/backup에 연결된 파일시스템부터 안전하게 해제한 뒤 상위 마운트를 점검해야 합니다.

    4. 사용 중인 프로세스를 안전하게 종료하는 방법

    fuser나 lsof로 PID를 확인했다면 먼저 해당 프로세스가 무엇인지 검증해야 합니다.

    ps -fp 3180

    서비스로 관리되는 프로세스라면 직접 PID를 종료하기보다 해당 서비스의 상태를 확인하는 것이 우선입니다.

    sudo systemctl status 서비스명

    정지해도 되는 서비스인지 확인했다면 정상적인 서비스 종료를 사용합니다.

    sudo systemctl stop 서비스명

    직접 실행한 프로세스라면 정상 종료 신호인 SIGTERM을 보낼 수 있습니다.

    sudo kill -15 3180

    프로세스가 종료됐는지 확인한 뒤 다시 마운트 해제를 시도합니다.

    ps -p 3180
    sudo fuser -vm /mnt/data
    sudo umount /mnt/data

    SIGTERM으로 종료되지 않는 경우에도 바로 강제 종료하기보다는 작업 상태와 서비스 영향을 확인해야 합니다.

    kill -9는 정상 종료 처리를 거치지 못하게 하므로 데이터 쓰기 작업이 진행 중인 프로세스에는 특히 주의가 필요합니다. 또한 커널의 중단 불가능한 대기 상태인 D 상태의 프로세스는 SIGKILL을 보내도 즉시 종료되지 않을 수 있습니다.

    5. Docker와 NFS 환경에서 오류가 발생하는 경우

    Docker 컨테이너가 호스트 디렉터리를 Bind Mount로 사용하고 있다면 호스트에서 해당 경로를 정리하려 할 때 마운트 관련 충돌이 발생할 수 있습니다.

    먼저 실행 중인 컨테이너를 확인합니다.

    docker ps

    특정 컨테이너의 마운트 설정을 확인하려면 다음과 같이 실행합니다.

    docker inspect 컨테이너명 --format '{{json .Mounts}}'

    해당 경로를 사용 중인 컨테이너가 확인됐다면 실제 운영 서비스에 영향을 주지 않는지 검토한 뒤 컨테이너를 정상적으로 중지하거나 마운트 설정을 수정해야 합니다.

    docker stop 컨테이너명

    NFS 같은 네트워크 파일시스템에서는 서버 연결 문제, 응답 지연, 마운트 참조 등으로 해제가 어려울 수 있습니다.

    findmnt -T /mnt/data
    sudo fuser -vm /mnt/data

    이때 마운트 해제를 무리하게 반복하거나 파일을 사용 중인 프로세스를 일괄 종료하기보다는 네트워크 파일시스템의 연결 상태와 작업 중인 서비스를 함께 확인해야 합니다.

    6. umount -l 또는 강제 해제를 사용해도 될까?

    일반적인 마운트 해제가 실패할 때 umount -l 또는 umount -f를 해결 방법으로 소개하는 경우가 있습니다. 하지만 두 옵션은 의미와 적용 범위가 다릅니다.

    umount -l은 Lazy Unmount로, 파일시스템을 현재 마운트 계층에서 분리하고 남아 있는 참조가 해제되면 정리를 완료하는 방식입니다.

    sudo umount -l /mnt/data

    이는 해당 파일시스템을 사용 중인 모든 프로세스가 종료됐다는 의미가 아닙니다. 따라서 일반적인 장애 해결 방법으로 무조건 사용하는 것은 권장하지 않습니다.

    umount -f는 강제 해제 옵션이지만 모든 파일시스템에서 동일하게 동작하는 것은 아니며, 특히 응답하지 않는 네트워크 파일시스템 등에서 신중하게 검토해야 합니다.

    sudo umount -f /mnt/data

    운영 서버에서는 프로세스 점유 확인 → 서비스 정상 종료 → 하위 마운트 확인 → 일반 umount 재시도를 먼저 수행하고, Lazy 또는 강제 해제는 위험과 복구 절차를 이해한 경우에만 검토하는 것이 안전합니다.

    실전 점검 순서

    예를 들어 /mnt/data를 마운트 해제할 때 target is busy 오류가 발생했다면 다음 순서로 점검합니다.

    # 1. 마운트 구조 확인
    findmnt -R /mnt/data
    
    # 2. 사용 중인 프로세스 확인
    sudo fuser -vm /mnt/data
    
    # 3. 열린 파일 확인
    sudo lsof +D /mnt/data
    
    # 4. PID 확인 후 상세 정보 조회
    ps -fp 3180
    
    # 5. 현재 작업 위치 변경
    cd /
    
    # 6. 원인을 해결한 뒤 다시 마운트 해제
    sudo umount /mnt/data
    
    # 7. 마운트 해제 여부 확인
    findmnt -M /mnt/data

    위 명령에서 PID 3180은 예시이므로 실제 서버에서 확인한 PID로 변경해야 합니다. 또한 프로세스를 종료하거나 마운트를 해제하기 전에는 서비스 영향과 데이터 쓰기 상태를 반드시 확인해야 합니다.

    정리

    리눅스 서버에서 Device or Resource Busy 오류가 발생했다면 단순한 파일 권한 문제로 판단하기보다 어떤 작업에서 오류가 발생했는지와 어떤 프로세스 또는 마운트가 해당 자원을 사용 중인지 확인하는 것이 우선입니다.

    마운트 해제 오류라면 findmnt로 마운트 구조를 확인하고, fuser와 lsof로 사용 중인 프로세스를 추적합니다. 그다음 서비스의 정상 종료나 작업 디렉터리 변경 등으로 원인을 해결한 뒤 umount를 다시 실행하면 됩니다.

    특히 kill -9, umount -l, umount -f 같은 명령은 상황에 따라 운영 중인 서비스에 영향을 줄 수 있으므로 원인을 확인하지 않은 상태에서 바로 실행하지 않는 것이 중요합니다.

  • 리눅스 서버에서 Stale File Handle 오류가 발생하는 이유와 해결 방법

    리눅스 서버에서 Stale File Handle 오류가 발생하는 이유와 해결 방법

    리눅스 서버에서 NFS로 연결된 공유 디렉터리에 접근하려는데 갑자기 Stale file handle 오류가 나타나는 경우가 있습니다. 평소 정상적으로 사용하던 경로에서 ls, df, stat 명령어가 실패하거나, 파일을 읽고 쓰던 애플리케이션이 갑자기 파일 접근 오류를 기록하기도 합니다.

    특히 NFS 서버를 재시작하거나 공유 디렉터리를 이동한 뒤, 스토리지 볼륨을 교체하거나 백업 데이터를 복원한 이후에 이런 문제가 발생할 수 있습니다. 파일이 실제로 존재하는데도 접근할 수 없어 권한 문제나 디스크 장애로 오해하기 쉽습니다.

    하지만 Stale File Handle 오류는 클라이언트가 보유한 파일 식별 정보가 서버에서 더 이상 유효하지 않을 때 발생하는 경우가 많습니다. 즉, 경로 이름이 그대로 남아 있어도 해당 파일이나 디렉터리를 가리키던 기존 파일 핸들이 무효화된 상태일 수 있습니다.

    이때 무조건 서버를 재부팅하거나 공유 디렉터리를 삭제하면 운영 중인 서비스에 추가 장애가 발생할 수 있습니다. 특히 여러 애플리케이션이 같은 NFS 마운트를 사용한다면 마운트 해제 전에 프로세스 점유 상태를 확인해야 합니다.

    이번 글에서는 오류 발생 경로 확인 → NFS 마운트 상태 분석 → 파일 핸들 무효화 원인 점검 → 프로세스 점유 확인 → 안전한 마운트 복구 순서로 해결 방법을 살펴봅니다.

    Stale File Handle 핵심 명령어 한눈에 보기

    오류가 발생했다면 먼저 해당 디렉터리가 어떤 파일시스템에 연결되어 있는지, NFS 서버와 마운트 상태가 정상인지 확인해야 합니다. 아래 예시에서는 /mnt/shared를 NFS 마운트 경로로 사용합니다.

    점검 목적 명령어
    마운트 정보 확인 findmnt -t nfs,nfs4
    NFS 마운트 목록 mount -t nfs,nfs4
    NFS 서버 연결 확인 ping -c 4 192.0.2.10
    파일 접근 오류 확인 stat /mnt/shared
    점유 프로세스 확인 sudo fuser -vm /mnt/shared
    NFS 클라이언트 통계 nfsstat -m
    마운트 해제 sudo umount /mnt/shared
    마운트 재연결 sudo mount /mnt/shared

    중요한 점은 오류가 발생한 경로가 실제로 NFS 마운트인지 먼저 확인하는 것입니다. Stale File Handle은 NFS에서 대표적으로 발생하지만 파일 핸들을 사용하는 다른 파일시스템이나 스토리지 환경에서도 발생할 수 있습니다.

    또한 ping이 성공했다고 해서 NFS 서비스가 정상적으로 동작한다는 의미는 아닙니다. 서버 연결과 파일시스템 접근 상태를 구분해서 확인해야 합니다.

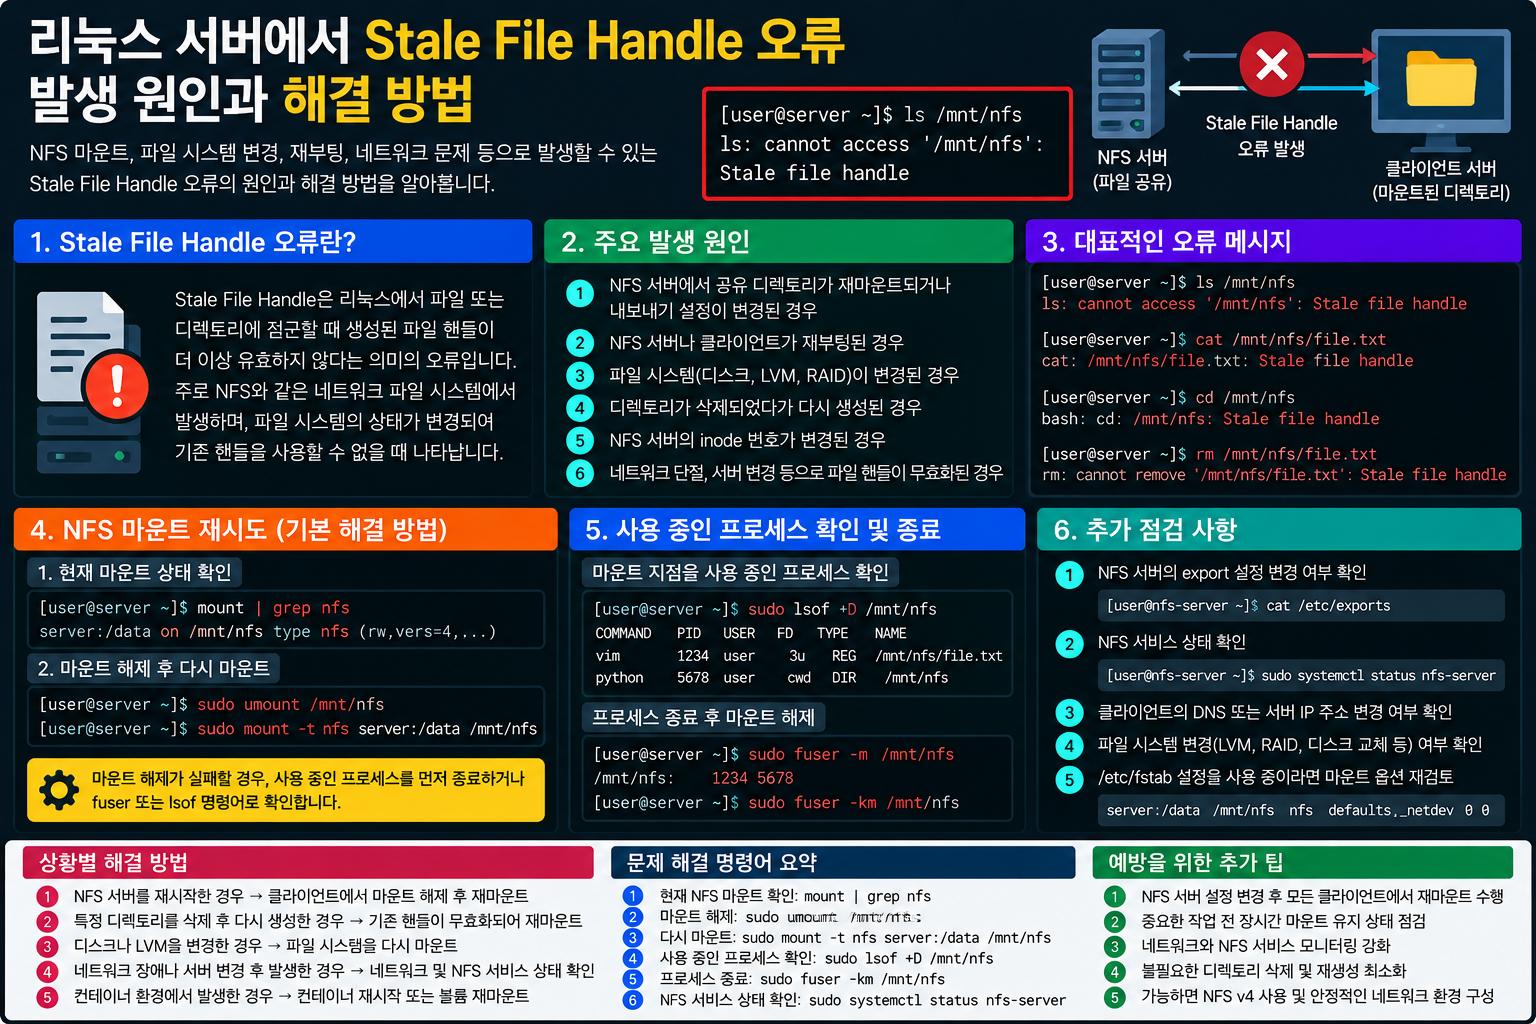
    리눅스 Stale File Handle 오류와 NFS 마운트 상태 확인 및 복구 방법
    NFS 공유 디렉터리에서 Stale File Handle 오류가 발생했을 때 마운트 상태와 프로세스 점유를 확인하는 예시입니다.

    1. Stale File Handle 오류가 발생하는 원인

    리눅스에서 Stale file handle은 일반적으로 ESTALE 오류와 관련이 있습니다.

    NFS 클라이언트는 원격 서버의 파일이나 디렉터리에 접근할 때 서버가 제공하는 파일 핸들을 사용합니다. 파일 핸들은 단순한 파일 이름이 아니라 서버가 해당 파일시스템 객체를 식별하기 위한 정보를 포함합니다.

    서버에서 파일이 삭제되거나 다른 객체로 교체되면 클라이언트가 이전에 저장한 파일 핸들이 더 이상 유효하지 않을 수 있습니다.

    대표적인 원인은 다음과 같습니다.

    • NFS 서버의 파일 변경: 기존 파일이나 디렉터리가 삭제되고 새 객체로 교체된 경우
    • 공유 디렉터리 재구성: NFS export 경로 또는 파일시스템 구성이 변경된 경우
    • 스토리지 복원: 스냅샷 복구나 볼륨 교체로 파일 식별 정보가 달라진 경우
    • 서버 재시작 후 변경: 재시작 과정에서 기존 파일 핸들이 더 이상 유효하지 않게 된 경우
    • 마운트 구성 변경: 클라이언트가 이전 파일시스템 객체를 계속 참조하는 경우
    • 애플리케이션의 오래된 참조: 프로세스가 삭제되거나 교체된 파일을 계속 사용하는 경우

    다만 NFS 서버를 재시작했다는 이유만으로 항상 Stale File Handle 오류가 발생하는 것은 아닙니다. 일반적인 서버 재시작 이후에도 기존 파일 핸들이 유효하게 유지될 수 있습니다.

    실제 원인은 서버의 파일시스템 객체나 export 구성이 어떻게 변경되었는지에 따라 달라집니다.

    2. 실제 Stale File Handle 오류 메시지 확인하기

    NFS 공유 디렉터리에서 문제가 발생하면 다음과 같은 메시지가 나타날 수 있습니다.

    $ ls -la /mnt/shared
    
    ls: cannot access '/mnt/shared':
    Stale file handle

    또는 특정 파일에 접근할 때 오류가 발생할 수 있습니다.

    $ stat /mnt/shared/report.csv
    
    stat: cannot statx '/mnt/shared/report.csv':
    Stale file handle

    이 메시지는 파일을 찾지 못했다는 No such file or directory 오류와 다릅니다.

    파일 이름이나 경로가 존재하는 것처럼 보여도 클라이언트가 참조하는 파일 핸들이 서버에서 더 이상 유효하지 않아 파일 정보를 조회하지 못하는 상황일 수 있습니다.

    특히 오류가 특정 파일에서만 발생하는지, 공유 디렉터리 전체에서 발생하는지 확인하면 문제 범위를 구분하는 데 도움이 됩니다.

    3. findmnt와 mount로 NFS 마운트 상태 확인하기

    가장 먼저 확인할 것은 오류가 발생한 경로가 어떤 원격 파일시스템에 연결되어 있는지입니다.

    findmnt -t nfs,nfs4

    다음은 출력 예시입니다.

    TARGET       SOURCE                 FSTYPE OPTIONS
    /mnt/shared  192.0.2.10:/exports/data nfs4   rw,relatime,vers=4.2

    주요 항목은 다음과 같습니다.

    • TARGET: 클라이언트의 마운트 경로
    • SOURCE: NFS 서버 주소와 공유 경로
    • FSTYPE: NFS 파일시스템 유형
    • OPTIONS: 적용된 마운트 옵션

    현재 마운트 목록을 확인하려면 다음 명령어도 사용할 수 있습니다.

    mount -t nfs,nfs4

    특정 경로의 마운트 정보를 확인할 때는 다음 명령어를 사용합니다.

    findmnt --mountpoint /mnt/shared

    단, 마운트 지점 자체가 아니라 하위 디렉터리에서 문제가 발생했다면 실제 경로에 적용되는 파일시스템을 별도로 확인해야 합니다.

    또한 findmnt에 마운트가 표시된다고 해서 NFS 서버가 현재 정상적으로 응답한다는 의미는 아닙니다.

    4. NFS 서버 연결과 커널 로그 점검하기

    NFS 서버와 통신이 불안정하면 파일 접근 오류나 응답 지연이 함께 발생할 수 있습니다.

    먼저 서버 연결 상태를 확인합니다.

    ping -c 4 192.0.2.10

    다만 ICMP가 차단된 환경에서는 ping이 실패해도 NFS 연결이 정상일 수 있습니다.

    NFSv4에서 일반적으로 사용하는 TCP 2049번 포트의 접근 가능 여부를 확인하려면 다음과 같이 사용할 수 있습니다.

    nc -vz -w 3 192.0.2.10 2049

    이 명령어는 TCP 포트 접근 가능 여부를 확인하는 것으로, NFS 파일 핸들의 유효성까지 검증하지는 않습니다.

    커널 로그에서도 관련 메시지를 검색합니다.

    sudo journalctl -k -b | grep -Ei 'nfs|stale|server not responding'

    예를 들어 다음과 같은 로그가 확인될 수 있습니다.

    nfs: server 192.0.2.10 not responding, still trying

    이 메시지는 서버 응답 지연이나 연결 문제를 나타낼 수 있지만 그 자체가 Stale File Handle의 직접적인 원인이라는 의미는 아닙니다.

    ESTALE 오류와 네트워크 타임아웃은 서로 다른 문제일 수 있으므로 로그 발생 시각과 서버 변경 이력을 함께 확인해야 합니다.

    5. NFS 마운트를 사용하는 프로세스 확인하기

    마운트를 해제하기 전에 해당 경로를 사용 중인 프로세스가 있는지 확인해야 합니다.

    sudo fuser -vm /mnt/shared

    다음은 설명을 위한 출력 예시입니다.

                         USER        PID ACCESS COMMAND
    /mnt/shared:         root       2451 ..c.. bash
                         app        3187 f.... python3

    여기서 PID는 프로세스 번호, COMMAND는 실행 중인 프로그램입니다.

    ACCESS 항목에서는 현재 작업 디렉터리나 열린 파일 등 마운트 사용 방식과 관련된 정보를 확인할 수 있습니다.

    다만 Stale File Handle 상태에서는 일부 파일 접근 및 프로세스 조회 명령어가 실패하거나 응답이 지연될 수 있습니다.

    운영 중인 데이터베이스, 웹 애플리케이션, 백업 프로세스가 해당 경로를 사용한다면 서비스 영향과 미완료 작업을 확인한 뒤 복구해야 합니다.

    6. NFS 마운트 해제와 재연결로 복구하기

    서버의 공유 경로와 파일시스템 구성이 정상이라는 사실을 확인했고, 마운트를 사용하는 서비스도 안전하게 중지할 수 있다면 마운트 해제와 재연결을 시도할 수 있습니다.

    먼저 해당 디렉터리에서 작업 중인 셸이나 프로세스를 정리합니다.

    그다음 정상적인 마운트 해제를 시도합니다.

    sudo umount /mnt/shared

    마운트 해제가 성공했다면 /etc/fstab에 해당 마운트가 등록되어 있는 경우 다음 명령어로 다시 연결할 수 있습니다.

    sudo mount /mnt/shared

    마운트가 복구됐는지 확인합니다.

    findmnt --mountpoint /mnt/shared
    ls -la /mnt/shared

    마운트 재연결은 클라이언트가 오래된 파일 핸들을 다시 획득하는 데 도움이 될 수 있지만, 서버의 export 설정이나 파일시스템 자체에 문제가 있다면 재마운트만으로 해결되지 않을 수 있습니다.

    또한 마운트 해제 이후에도 기존 파일 핸들을 보유한 애플리케이션은 정상적으로 복구되지 않을 수 있으므로 필요하다면 해당 애플리케이션을 안전하게 다시 시작해야 합니다.

    7. Device or Resource Busy 오류로 마운트 해제가 실패하는 경우

    NFS 마운트를 해제하려는데 다음과 같은 메시지가 나타날 수 있습니다.

    umount: /mnt/shared: target is busy.

    이는 해당 마운트를 사용 중인 프로세스나 하위 마운트 등이 존재할 때 발생할 수 있습니다.

    먼저 사용 중인 프로세스를 확인합니다.

    sudo fuser -vm /mnt/shared

    하위 마운트가 있는지도 확인합니다.

    findmnt -R /mnt/shared

    문제의 원인이 된 서비스를 확인한 뒤 가능하면 서비스 관리자를 통해 정상 종료해야 합니다.

    일반적인 프로세스라면 종료 가능 여부를 판단한 후 SIGTERM으로 정상 종료를 요청할 수 있습니다.

    kill -15 3187

    여기서 PID는 실제 확인된 프로세스 번호로 변경해야 합니다.

    kill -9는 마지막 수단이며, NFS I/O를 기다리는 프로세스가 커널의 인터럽트 불가능한 대기 상태에 있다면 즉시 종료되지 않을 수 있습니다.

    따라서 마운트가 사용 중이라는 이유만으로 모든 관련 프로세스를 강제 종료해서는 안 됩니다.

    8. umount -l 또는 umount -f를 사용해도 될까?

    마운트 해제가 실패할 때 다음 명령어를 해결 방법으로 소개하는 경우가 있습니다.

    sudo umount -l /mnt/shared

    -l은 lazy unmount 옵션입니다. 마운트 지점을 현재 파일시스템 네임스페이스에서 분리하고, 기존 참조가 해제되면 실제 정리가 완료되는 방식입니다.

    따라서 명령어가 성공했다고 해서 기존 프로세스가 보유한 파일 핸들이 즉시 모두 해제되거나 NFS 연결이 완전히 정상화됐다고 볼 수는 없습니다.

    다음 명령어는 강제 마운트 해제 옵션입니다.

    sudo umount -f /mnt/shared

    다만 -f의 동작은 파일시스템과 커널 구현에 따라 달라지며, NFS 연결이 응답하지 않는 상황에서도 항상 성공하는 것은 아닙니다.

    운영 서버에서는 정상적인 마운트 해제와 서비스 종료를 먼저 시도하고, lazy 또는 force 옵션은 복구 절차와 영향 범위를 충분히 확인한 뒤 마지막 수단으로 검토하는 것이 좋습니다.

    9. Stale File Handle 오류가 반복되는 경우 확인할 사항

    재마운트 후에도 오류가 반복된다면 클라이언트 문제가 아니라 NFS 서버의 파일시스템 구성이나 애플리케이션 동작 방식에 원인이 있을 수 있습니다.

    특히 다음 사항을 점검해야 합니다.

    • 공유 경로 변경: NFS export 디렉터리가 이동되거나 교체됐는지 확인
    • 파일시스템 교체: 서버의 공유 볼륨이 다른 파일시스템으로 변경됐는지 확인
    • 스냅샷 복원: 복원 과정에서 기존 파일 핸들이 무효화됐는지 확인
    • 애플리케이션 배포: 디렉터리를 삭제한 뒤 같은 이름으로 다시 생성하는 작업이 있는지 확인
    • 클러스터 구성: 여러 NFS 서버가 일관된 파일 핸들을 제공하는지 확인
    • 스토리지 로그: 서버 측 파일시스템 오류나 export 변경 기록 확인

    특히 디렉터리를 삭제한 뒤 같은 이름으로 다시 생성하는 배포 방식은 기존 디렉터리를 참조하던 클라이언트에 영향을 줄 수 있습니다.

    NFS 서버 관리 권한이 있다면 공유 설정과 실제 파일시스템 마운트 상태를 함께 점검해야 합니다.

    다만 NFS 서버의 export 설정을 무작정 변경하거나 서비스를 반복해서 재시작하면 다른 클라이언트에도 영향을 줄 수 있으므로 주의해야 합니다.

    실전 점검 순서

    리눅스 서버에서 Stale File Handle 오류가 발생했다면 다음 순서로 점검할 수 있습니다.

    # 1. NFS 마운트 목록 확인
    findmnt -t nfs,nfs4
    
    # 2. 오류 경로의 마운트 확인
    findmnt --mountpoint /mnt/shared
    
    # 3. 파일 접근 오류 확인
    stat /mnt/shared
    
    # 4. NFS 클라이언트 마운트 통계
    nfsstat -m
    
    # 5. 커널 로그 확인
    sudo journalctl -k -b | grep -Ei 'nfs|stale|server not responding'
    
    # 6. 마운트를 사용하는 프로세스 확인
    sudo fuser -vm /mnt/shared
    
    # 7. 하위 마운트 확인
    findmnt -R /mnt/shared
    
    # 8. 서비스 영향 확인 후 마운트 해제
    sudo umount /mnt/shared
    
    # 9. fstab에 등록된 마운트 재연결
    sudo mount /mnt/shared
    
    # 10. 복구 상태 확인
    findmnt --mountpoint /mnt/shared
    ls -la /mnt/shared

    위 명령어는 정상적인 NFS 서버 연결과 공유 경로 구성이 확인된 환경을 기준으로 작성한 예시입니다.

    실제 운영 환경에서는 마운트를 사용하는 애플리케이션을 먼저 확인하고, 데이터 손실이나 서비스 중단 가능성을 검토한 뒤 마운트 해제와 재연결을 진행해야 합니다.

    정리

    리눅스 서버에서 Stale File Handle 오류가 발생하는 이유는 대부분 클라이언트가 보유한 파일 핸들이 NFS 서버에서 더 이상 유효하지 않기 때문입니다.

    특히 공유 디렉터리 변경, 파일시스템 교체, 스냅샷 복원, 오래된 파일 참조 등이 대표적인 원인입니다.

    먼저 findmnt와 mount로 마운트 상태를 확인하고, fuser로 해당 경로를 사용하는 프로세스를 확인해야 합니다.

    서버 구성이 정상이고 서비스 중단이 가능한 상황이라면 마운트 해제 후 재연결을 시도할 수 있습니다. 하지만 서버의 파일시스템 객체나 export 구성이 변경된 상태라면 근본 원인을 먼저 해결해야 합니다.

    핵심 점검 순서는 오류 경로 확인 → NFS 상태 점검 → 서버 변경 이력 분석 → 프로세스 점유 확인 → 안전한 재마운트 → 재발 원인 제거입니다.

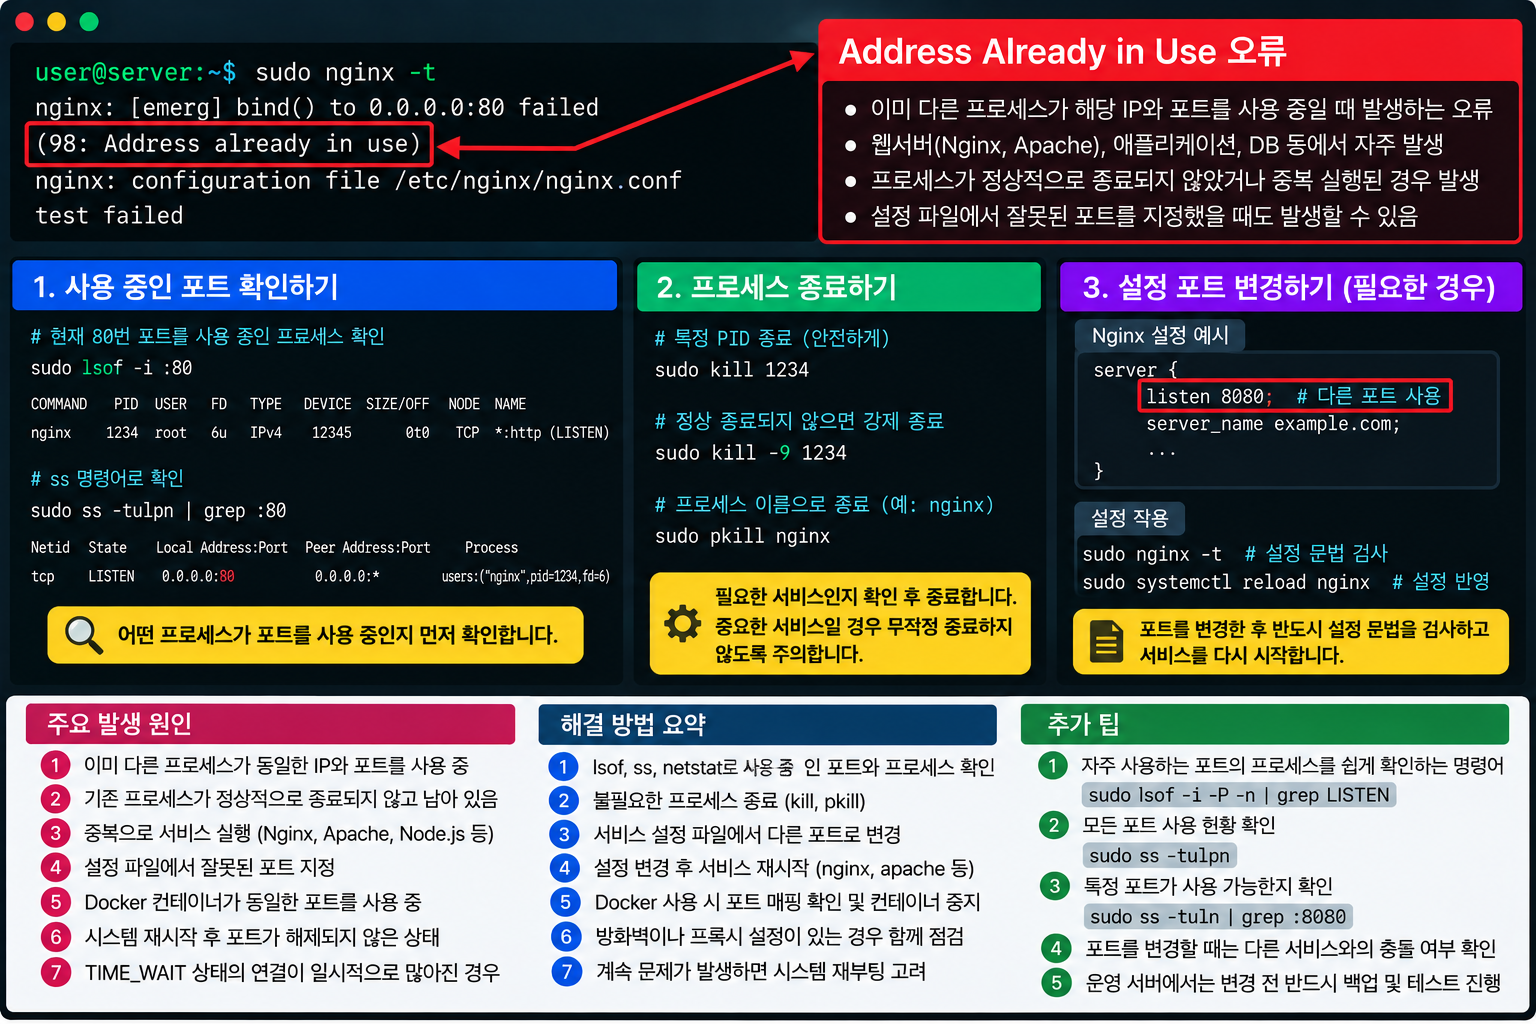
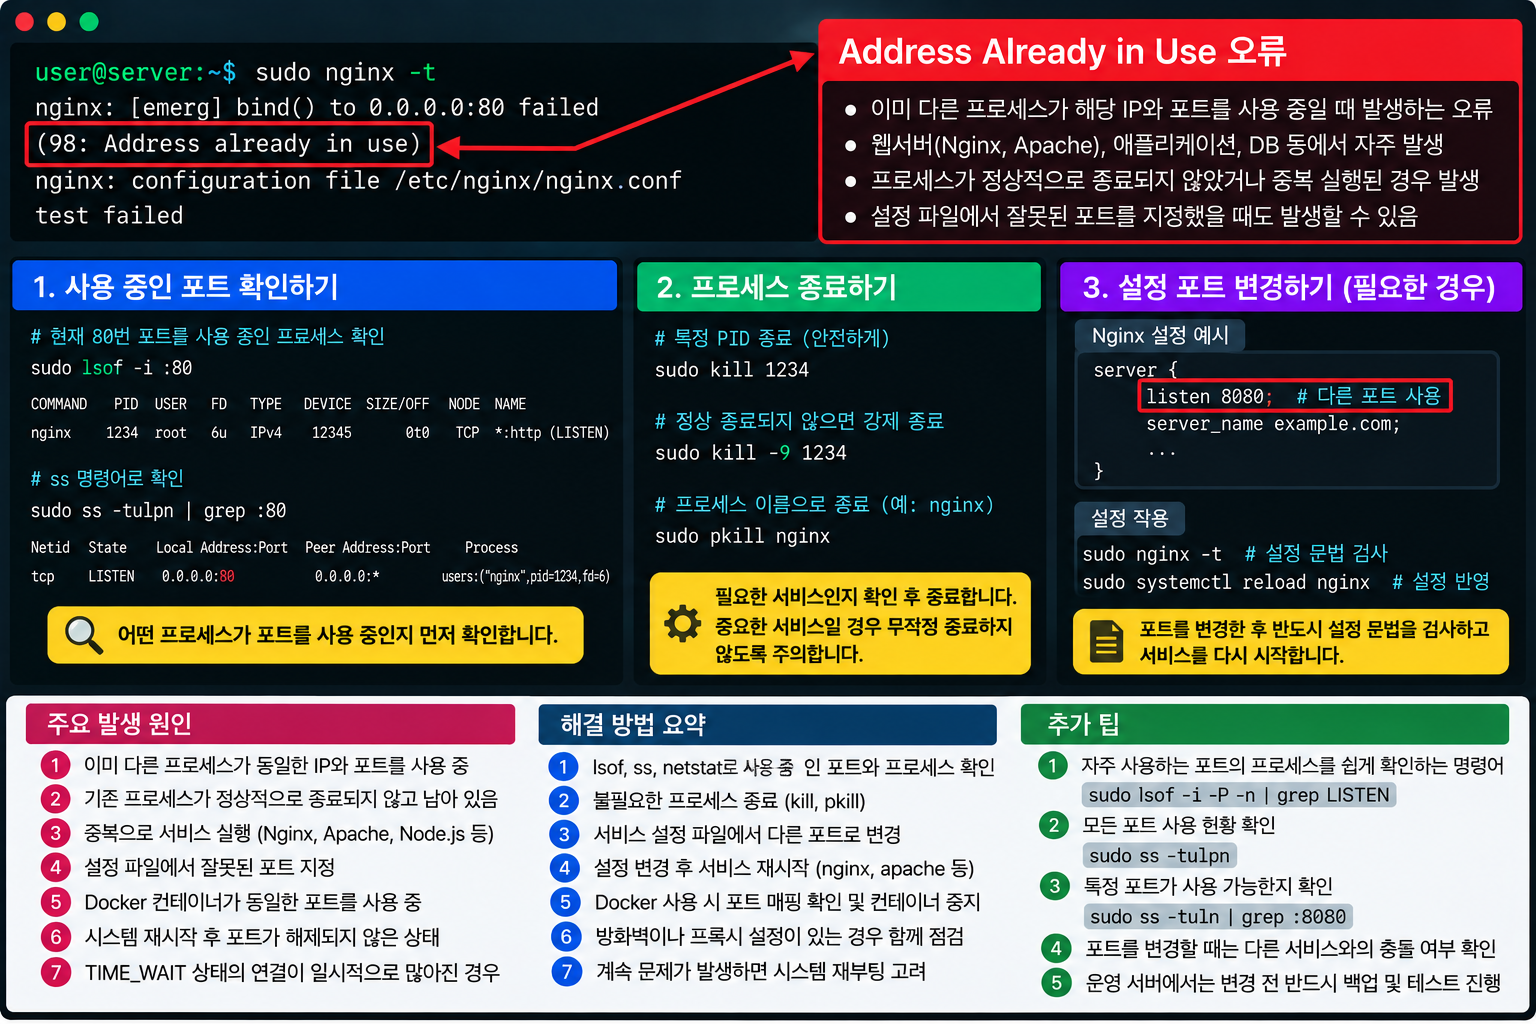
  • 서버에서 Address Already in Use 오류가 발생할 때 해결 방법

    서버에서 Address Already in Use 오류가 발생할 때 해결 방법

    리눅스 서버에서 프로그램을 실행하거나 새로운 프로세스를 생성하려는데 갑자기 Cannot allocate memory 오류가 발생하는 경우가 있습니다. SSH 접속은 정상적으로 되지만 명령어 실행이 실패하거나, Python·Java·MySQL 같은 애플리케이션이 시작되지 않는 현상도 나타날 수 있습니다.

    이런 오류가 발생하면 서버의 RAM이 모두 사용됐다고 생각하기 쉽습니다. 하지만 실제 물리 메모리가 부족한 경우뿐 아니라 Swap 부족, 프로세스의 가상 메모리 제한, 컨테이너 메모리 제한, 커널의 메모리 할당 정책 때문에도 문제가 발생할 수 있습니다.

    특히 free -h에서 사용 가능한 메모리가 남아 있는데도 fork: Cannot allocate memory가 발생한다면 단순히 RAM 사용량만 확인해서는 원인을 찾기 어렵습니다.

    이번 글에서는 메모리 상태 확인 → 프로세스별 사용량 분석 → OOM Killer 로그 점검 → Swap 및 시스템 제한 확인 → 원인별 해결 순서로 서버를 안전하게 점검하는 방법을 살펴봅니다.

    Cannot Allocate Memory 핵심 명령어 한눈에 보기

    오류가 발생했다면 먼저 아래 명령어로 시스템 메모리와 프로세스 상태를 확인합니다. 메모리가 심하게 부족한 서버에서는 새 명령어 실행 자체가 실패할 수 있으므로 가능하면 기존 SSH 세션이나 서버 콘솔을 유지한 상태에서 점검해야 합니다.

    점검 목적명령어
    RAM·Swap 사용량free -h
    메모리 상태 변화vmstat 1 5
    메모리 사용 상위 프로세스ps aux --sort=-rss | head -n 15
    OOM 관련 커널 로그sudo journalctl -k -b | grep -Ei 'out of memory|oom|killed process'
    메모리 커밋 상태grep -E 'CommitLimit|Committed_AS' /proc/meminfo
    프로세스 자원 제한ulimit -a
    Swap 장치 확인swapon --show

    가장 먼저 확인할 값은 단순한 free 메모리보다 실제로 새 작업에 사용할 수 있는 메모리를 추정하는 available 값입니다. 다만 available이 충분해 보여도 메모리 커밋 제한이나 cgroup 제한 등으로 할당에 실패할 수 있습니다.

    리눅스 Cannot Allocate Memory 오류와 free vmstat OOM 메모리 점검 방법
    Cannot Allocate Memory 오류 발생 시 RAM, Swap, 메모리 사용 프로세스와 OOM 로그를 확인하는 예시입니다.

    1. Cannot Allocate Memory 오류가 발생하는 이유

    리눅스에서 Cannot allocate memory는 일반적으로 ENOMEM 오류와 관련이 있습니다. 프로그램이 메모리 할당이나 프로세스 생성에 필요한 자원을 확보하지 못했을 때 나타날 수 있습니다.

    예를 들어 새로운 프로세스를 실행하려 할 때 다음과 같은 메시지가 표시될 수 있습니다.

    bash: fork: Cannot allocate memory

    또는 Python 프로그램에서 메모리 할당이 실패하면 다음과 같은 오류가 발생할 수 있습니다.

    MemoryError

    두 오류 모두 메모리 자원 문제와 관련될 수 있지만 발생 위치와 직접적인 원인은 다를 수 있습니다.

    대표적인 원인은 다음과 같습니다.

    • 물리 메모리 부족: 실행 중인 프로세스가 사용 가능한 RAM을 대부분 소비한 경우
    • Swap 부족: 메모리 압박 상황에서 추가적인 여유 공간이 부족한 경우
    • 메모리 커밋 제한: 커널의 overcommit 정책에 따라 새로운 메모리 예약이 거부된 경우
    • 프로세스 자원 제한: 주소 공간 크기 등 사용자 또는 프로세스별 제한에 도달한 경우
    • 컨테이너 제한: Docker나 Kubernetes의 메모리 제한에 도달한 경우
    • 커널 메모리 할당 문제: 특정 크기나 유형의 메모리 할당이 실패한 경우
    • 애플리케이션 메모리 증가: 메모리 누수나 과도한 캐시 사용으로 사용량이 계속 늘어난 경우

    따라서 메모리 부족 메시지가 나타났다고 해서 무조건 서버 RAM을 증설하거나 Swap부터 추가하는 것은 적절하지 않을 수 있습니다.

    2. free -h로 RAM과 Swap 사용량 확인하기

    가장 기본적인 점검은 free 명령어입니다.

    free -h

    다음은 설명을 위한 출력 예시입니다.

                   total   used   free  shared  buff/cache  available
    Mem:            7.7Gi  6.2Gi  210Mi   120Mi      1.3Gi      890Mi
    Swap:           2.0Gi  1.7Gi  350Mi

    여기서 중요한 항목은 다음과 같습니다.

    • total: 전체 메모리 크기
    • used: 사용 중인 메모리의 추정치
    • free: 현재 사용되지 않는 메모리
    • buff/cache: 버퍼와 파일 캐시 등으로 사용되는 메모리
    • available: 새로운 작업에 사용할 수 있는 메모리의 추정치

    리눅스는 남는 메모리를 파일 캐시 등에 활용하므로 free 값이 작다는 사실만으로 메모리가 부족하다고 판단하면 안 됩니다.

    또한 Swap 사용량이 높다는 이유만으로 현재 메모리 부족 상태라고 단정할 수도 없습니다. Swap에 오래전에 이동된 페이지가 남아 있을 수 있기 때문입니다.

    실제 메모리 압박 여부는 available 값과 함께 Swap 입출력, 프로세스 사용량, OOM 로그를 비교해야 합니다.

    3. vmstat로 메모리 부족과 Swap 활동 확인하기

    메모리 부족이 일시적인지 지속적인지 확인하려면 vmstat 명령어를 사용할 수 있습니다.

    vmstat 1 5

    이 명령어는 1초 간격으로 시스템 상태를 5회 출력합니다.

    메모리 관련 항목에서는 swpd, free, si, so 값을 확인합니다.

    • swpd: 사용 중인 가상 메모리의 Swap 양
    • si: Swap에서 메모리로 읽어 들이는 양
    • so: 메모리에서 Swap으로 내보내는 양
    • free: 사용하지 않는 메모리 양

    si와 so 값이 반복적으로 높게 나타나고 서버 응답 속도도 느려진다면 메모리 압박으로 인해 Swap 입출력이 활발하게 발생하는 상황일 수 있습니다.

    단, vmstat의 첫 번째 출력 행은 일반적으로 부팅 이후의 평균 통계를 포함하므로 실시간 상태를 분석할 때는 이후 출력 행도 함께 확인해야 합니다.

    4. 메모리를 많이 사용하는 프로세스 찾기

    메모리 사용량이 비정상적으로 높다면 어떤 프로세스가 메모리를 소비하고 있는지 확인해야 합니다.

    ps aux --sort=-rss | head -n 15

    위 명령어는 RSS 기준으로 메모리 사용량이 큰 프로세스를 확인하는 데 사용할 수 있습니다.

    주요 항목은 다음과 같습니다.

    • PID: 프로세스 식별 번호
    • %MEM: 물리 메모리 대비 사용 비율
    • VSZ: 프로세스의 가상 주소 공간 크기
    • RSS: 실제 메모리에 상주하는 메모리 크기
    • COMMAND: 실행 중인 프로그램

    특히 특정 프로세스의 RSS가 계속 증가한다면 애플리케이션의 메모리 누수나 캐시 정책을 점검할 필요가 있습니다.

    다만 RSS에는 공유 메모리도 포함될 수 있으므로 여러 프로세스의 RSS를 단순 합산하면 실제 물리 메모리 사용량과 차이가 날 수 있습니다.

    원인이 확인되지 않은 상태에서 메모리 사용량이 높다는 이유만으로 프로세스를 강제 종료하면 데이터 손실이나 서비스 장애가 발생할 수 있습니다.

    5. OOM Killer 로그 확인하기

    리눅스 커널은 메모리 부족 상황에서 시스템을 보호하기 위해 OOM Killer를 통해 프로세스를 종료할 수 있습니다.

    최근 부팅 이후의 커널 로그에서 관련 메시지를 검색합니다.

    sudo journalctl -k -b | grep -Ei 'out of memory|oom|killed process'

    OOM이 발생한 경우 다음과 비슷한 메시지가 기록될 수 있습니다.

    Out of memory: Killed process 2481 (java)
    total-vm:4194304kB, anon-rss:2097152kB

    위 예시는 커널이 메모리 부족 상황에서 Java 프로세스를 종료한 경우를 나타냅니다.

    다만 Cannot Allocate Memory 오류가 발생했다고 해서 반드시 OOM Killer가 실행되는 것은 아닙니다. 메모리 할당이 거부되더라도 프로세스 종료 없이 오류만 반환될 수 있습니다.

    또한 OOM 로그가 없다고 해서 메모리 부족 문제가 없었다고 단정할 수 없습니다. 로그 보존 상태와 커널 설정, 컨테이너 환경에 따라 확인 가능한 정보가 달라질 수 있습니다.

    6. RAM이 남아 있는데 Cannot Allocate Memory가 발생하는 이유

    free -h에서 available 메모리가 충분해 보여도 새로운 메모리 할당이 실패할 수 있습니다.

    대표적으로 커널의 메모리 커밋 정책을 확인해야 하는 경우가 있습니다.

    cat /proc/sys/vm/overcommit_memory

    이 값은 커널이 메모리 할당 요청을 어떻게 판단할지 결정하는 설정입니다.

    • 0: 커널의 휴리스틱에 따라 메모리 커밋을 판단
    • 1: 메모리 커밋을 폭넓게 허용
    • 2: 설정된 커밋 한도에 따라 엄격하게 제한

    현재 커밋 상태는 다음 명령어로 확인합니다.

    grep -E 'CommitLimit|Committed_AS' /proc/meminfo

    Committed_AS가 CommitLimit에 가까운 상황에서 엄격한 overcommit 정책이 적용되고 있다면 새로운 메모리 예약이 거부될 수 있습니다.

    다만 문제를 해결하기 위해 vm.overcommit_memory=1로 무조건 변경하는 것은 권장하지 않습니다. 실제 메모리 부족 위험이 사라지는 것이 아니라 메모리 할당 실패 시점과 시스템 동작이 달라질 수 있기 때문입니다.

    7. ulimit과 프로세스별 메모리 제한 확인하기

    특정 사용자나 프로그램에서만 오류가 발생한다면 프로세스별 자원 제한을 확인할 필요가 있습니다.

    ulimit -a

    특히 다음 항목을 확인합니다.

    • virtual memory: 프로세스의 가상 주소 공간 크기 제한
    • data seg size: 데이터 세그먼트 크기 제한
    • max user processes: 사용자에게 적용되는 프로세스 수 제한

    프로세스 수 제한에 도달하면 일반적으로 Resource temporarily unavailable와 같은 다른 오류가 발생할 수 있으므로 메모리 할당 실패와 구분해야 합니다.

    또한 systemd로 실행하는 서비스에는 셸의 ulimit과 별도로 자원 제한이 적용될 수 있습니다.

    systemctl show myservice.service -p MemoryMax -p LimitAS -p LimitDATA

    위 명령어의 myservice.service는 실제 서비스 이름으로 변경해야 합니다.

    특정 서비스에서만 문제가 발생한다면 시스템 전체 메모리와 서비스별 제한을 함께 확인하는 것이 중요합니다.

    8. Docker 컨테이너에서 메모리 부족이 발생하는 경우

    Docker 컨테이너는 호스트 서버에 RAM이 충분히 남아 있어도 컨테이너에 설정된 메모리 제한에 도달할 수 있습니다.

    실시간 컨테이너 메모리 사용량을 확인합니다.

    docker stats --no-stream

    특정 컨테이너의 메모리 제한과 OOM 종료 여부를 확인하려면 다음 명령어를 사용할 수 있습니다.

    docker inspect mycontainer \
      --format 'Memory={{.HostConfig.Memory}} OOMKilled={{.State.OOMKilled}}'

    Memory 값은 바이트 단위이며, 0이면 Docker의 해당 메모리 제한이 설정되지 않았다는 의미입니다.

    OOMKilled가 true라면 컨테이너가 OOM 상황으로 종료됐음을 나타낼 수 있습니다. 다만 현재 상태와 종료 이력에 따라 추가 로그 확인이 필요할 수 있습니다.

    컨테이너의 메모리 제한을 높이기 전에 애플리케이션이 정상적으로 메모리를 사용하는지, 메모리 누수가 있는지 먼저 확인해야 합니다.

    9. Swap 추가가 필요한 상황과 주의할 점

    서버에 Swap이 없거나 메모리 압박이 반복된다면 Swap 구성을 검토할 수 있습니다.

    swapon --show
    free -h

    Swap은 메모리 부족 상황에서 일부 페이지를 디스크로 이동할 수 있도록 지원하지만 RAM을 대체하는 고속 메모리는 아닙니다.

    특히 디스크가 느리거나 메모리 부족이 지속되는 서버에서는 Swap 사용량 증가로 응답 지연이 심해질 수 있습니다.

    또한 Swap을 추가한다고 해서 프로세스의 주소 공간 제한, 컨테이너 메모리 제한, 특정 메모리 할당 실패가 모두 해결되는 것은 아닙니다.

    따라서 실제 메모리 압박이 확인됐을 때 워크로드와 저장장치 성능을 고려해 Swap 크기를 결정해야 합니다.

    실전 점검 순서

    리눅스 서버에서 Cannot Allocate Memory 오류가 반복된다면 다음 순서로 원인을 좁힐 수 있습니다.

    # 1. 전체 RAM과 Swap 확인
    free -h
    
    # 2. 메모리와 Swap 활동 확인
    vmstat 1 5
    
    # 3. 메모리 사용량이 큰 프로세스 확인
    ps aux --sort=-rss | head -n 15
    
    # 4. OOM Killer 로그 검색
    sudo journalctl -k -b | grep -Ei 'out of memory|oom|killed process'
    
    # 5. Swap 장치 확인
    swapon --show
    
    # 6. 메모리 커밋 정책 확인
    cat /proc/sys/vm/overcommit_memory
    
    # 7. 커밋 사용량 확인
    grep -E 'CommitLimit|Committed_AS' /proc/meminfo
    
    # 8. 현재 셸의 자원 제한 확인
    ulimit -a

    Docker나 systemd 서비스에서만 문제가 발생한다면 해당 컨테이너 또는 서비스에 적용된 메모리 제한도 추가로 확인합니다.

    메모리 사용량이 높은 프로세스를 발견했다면 서비스의 정상적인 사용 패턴인지, 특정 요청 이후 급격히 증가하는지, 재시작 이후에도 반복되는지 비교해야 합니다.

    운영 서버에서는 원인을 확인하기 전에 캐시를 강제로 비우거나 프로세스를 무작정 종료하는 방법을 우선 사용하지 않는 것이 좋습니다.

    정리

    리눅스 서버에서 Cannot Allocate Memory 오류가 발생하는 이유는 단순한 RAM 부족만이 아닙니다. Swap 부족, 메모리 커밋 정책, 프로세스별 자원 제한, Docker 메모리 제한 등 여러 요인이 영향을 줄 수 있습니다.

    먼저 free -h로 전체 메모리를 확인하고, vmstat로 메모리 압박을 점검한 뒤, 프로세스 사용량과 OOM 로그를 함께 분석하는 것이 좋습니다.

    특히 사용 가능한 RAM이 남아 있는데도 오류가 발생한다면 메모리 커밋 제한과 서비스·컨테이너별 메모리 제한을 확인해야 합니다.

    핵심 점검 순서는 RAM·Swap 확인 → 메모리 사용 프로세스 분석 → OOM 로그 점검 → 시스템 제한 확인 → 원인에 맞는 설정 변경입니다.

  • 서버에서 Broken Pipe 오류가 반복적으로 발생하는 원인과 해결 방법

    서버에서 Broken Pipe 오류가 반복적으로 발생하는 원인과 해결 방법

    SSH로 서버에 접속해 작업하던 중 갑자기 client_loop: send disconnect: Broken pipe 오류가 나타나면서 연결이 끊어진 경험이 있으신가요? 또는 Nginx와 애플리케이션 서버를 운영하면서 로그에 Broken pipe나 Errno 32 메시지가 반복적으로 기록되는 경우도 있습니다.

    특히 SSH 접속을 장시간 유지하거나, 대용량 파일을 전송하거나, 웹서버에서 응답 시간이 긴 요청을 처리할 때 이런 문제가 나타날 수 있습니다. 처음에는 서버가 다운됐거나 네트워크가 완전히 끊어졌다고 생각하기 쉽지만, 실제로는 상대방이 이미 연결을 종료했거나 TCP 연결이 더 이상 정상적으로 유지되지 않는 상태에서 데이터를 전송하려 할 때 발생하는 경우가 많습니다.

    다만 Broken Pipe는 특정 프로그램 하나의 오류가 아닙니다. SSH 클라이언트, Python 애플리케이션, 웹서버, 프록시 서버 등 어느 계층에서 메시지가 발생했는지에 따라 점검해야 할 원인이 달라집니다.

    이번 글에서는 Broken Pipe 오류 메시지 구분 → TCP 연결 상태 확인 → SSH KeepAlive 점검 → Nginx와 애플리케이션 로그 분석 → 안전한 설정 변경 순서로 반복적인 연결 종료 문제를 진단하는 방법을 살펴봅니다.

    Broken Pipe 핵심 명령어 한눈에 보기

    오류가 발생했다면 먼저 어떤 프로그램에서 메시지가 출력됐는지 확인해야 합니다. 아래 명령어는 Linux와 OpenSSH 환경에서 사용할 수 있는 대표적인 점검 방법입니다.

    점검 목적 명령어
    SSH 상세 로그 ssh -vvv user@server.example.com
    SSH 클라이언트 설정 ssh -G server.example.com
    TCP 연결 상태 ss -tan
    SSH 서버 로그 sudo journalctl -u sshd -n 100
    Nginx 오류 로그 sudo tail -n 100 /var/log/nginx/error.log
    네트워크 경로 확인 tracepath server.example.com

    Ubuntu와 Debian 계열에서는 SSH 서비스 이름이 ssh인 경우가 많으므로 journalctl -u ssh를 사용해야 할 수 있습니다. 또한 tracepath는 별도 패키지 설치가 필요할 수 있습니다.

    서버 Broken Pipe 오류 메시지와 SSH 연결 상태 점검 화면
    SSH 연결 중 Broken Pipe 오류가 발생했을 때 연결 로그와 TCP 상태를 확인하는 터미널 화면 예시입니다.

    1. Broken Pipe 오류는 어떤 상황에서 발생할까?

    리눅스에서 Broken pipe는 일반적으로 EPIPE 오류와 관련이 있습니다. 파이프 또는 소켓의 상대편이 더 이상 데이터를 받지 않는 상태에서 쓰기 작업을 시도할 때 발생할 수 있습니다.

    예를 들어 서버에서 다음과 같은 오류가 표시될 수 있습니다.

    client_loop: send disconnect: Broken pipe

    또는 Python 애플리케이션에서는 다음과 같이 나타날 수 있습니다.

    BrokenPipeError: [Errno 32] Broken pipe

    이 두 메시지는 모두 Broken Pipe와 관련이 있지만 동일한 원인으로 발생했다고 단정할 수는 없습니다.

    • SSH: 연결이 끊어진 상태에서 클라이언트가 데이터를 보내려는 경우
    • 웹 애플리케이션: 클라이언트가 응답을 기다리지 않고 연결을 종료한 경우
    • 프록시 환경: 중간 프록시 또는 로드밸런서가 연결을 종료한 경우
    • 파일 전송: 전송 도중 네트워크 연결이 끊기거나 상대 프로세스가 종료된 경우
    • 셸 파이프라인: 데이터를 받는 명령어가 먼저 종료된 경우

    따라서 오류가 발생한 위치를 구분하지 않고 SSH 설정이나 Nginx 타임아웃만 변경하는 것은 올바른 접근이 아닙니다.

    2. SSH 접속 중 Broken Pipe가 반복되는 경우

    SSH 연결을 장시간 유지하다가 갑자기 끊기는 경우라면 클라이언트와 서버 사이의 네트워크 연결 상태부터 확인해야 합니다.

    특히 방화벽, NAT 장비, VPN 또는 로드밸런서가 오랫동안 데이터 전송이 없는 연결을 정리하면서 문제가 발생할 수 있습니다.

    먼저 상세 로그를 활성화해 SSH에 접속합니다.

    ssh -vvv user@server.example.com

    연결이 끊어지는 시점의 로그를 확인하면 키 교환, 인증, 세션 유지 또는 데이터 전송 중 어느 단계에서 문제가 발생했는지 판단하는 데 도움이 됩니다.

    현재 적용되는 SSH 클라이언트 설정은 다음과 같이 확인할 수 있습니다.

    ssh -G server.example.com | grep -Ei 'serveralive|tcpkeepalive'

    여기서 ServerAliveInterval은 SSH 클라이언트가 일정 시간 동안 서버로부터 데이터를 받지 못했을 때 서버에 응답을 요청하는 간격을 지정합니다.

    ServerAliveCountMax는 응답이 없는 상태에서 허용할 연속적인 서버 응답 요청 횟수와 관련된 설정입니다.

    이 값들은 네트워크 장비의 유휴 연결 정리 문제를 완화하는 데 도움이 될 수 있지만, 실제 네트워크 장애를 복구하거나 모든 연결 끊김을 방지하는 설정은 아닙니다.

    3. SSH KeepAlive 설정으로 유휴 연결 끊김 완화하기

    SSH 접속이 일정 시간 사용하지 않았을 때만 반복적으로 끊긴다면 클라이언트의 KeepAlive 설정을 검토할 수 있습니다.

    먼저 현재 접속에만 옵션을 적용해 테스트합니다.

    ssh -o ServerAliveInterval=60 \
        -o ServerAliveCountMax=3 \
        user@server.example.com

    위 설정은 서버로부터 데이터를 받지 못한 시간이 60초에 도달하면 서버 응답을 요청하도록 구성합니다. 연속적으로 응답이 없으면 설정에 따라 연결을 종료할 수 있습니다.

    테스트 결과 유휴 상태에서의 연결 끊김이 줄어든다면 클라이언트 설정 파일에 해당 서버에 대한 설정을 추가할 수 있습니다.

    Host myserver
        HostName server.example.com
        User user
        ServerAliveInterval 60
        ServerAliveCountMax 3

    위 내용은 SSH 클라이언트의 ~/.ssh/config에 추가하는 예시입니다.

    모든 서버에 일괄 적용하기보다 실제로 문제가 발생하는 서버에만 설정한 뒤 연결 안정성을 확인하는 것이 좋습니다.

    4. SSH 서버 측 ClientAlive 설정 확인하기

    클라이언트 설정으로 문제가 해결되지 않는다면 SSH 서버의 연결 유지 및 세션 종료 설정을 확인할 수 있습니다.

    서버에서 현재 적용되는 SSHD 설정을 확인합니다.

    sudo sshd -T | grep -Ei 'clientalive|tcpkeepalive'

    SSH 서버에서는 ClientAliveInterval과 ClientAliveCountMax 설정을 사용할 수 있습니다.

    예를 들어 다음과 같은 설정을 검토할 수 있습니다.

    ClientAliveInterval 60
    ClientAliveCountMax 3

    다만 이 설정은 SSH 서버가 클라이언트의 응답 상태를 확인하는 데 사용되며, 유휴 연결을 무조건 유지하는 기능과 동일하지 않습니다.

    설정을 변경해야 한다면 기존 SSH 세션을 유지한 상태에서 설정 파일의 문법을 먼저 검사해야 합니다.

    sudo sshd -t

    설정이 정상임을 확인한 뒤 실제 서비스 이름과 운영 환경에 맞게 SSH 서비스를 다시 불러오거나 재시작할 수 있습니다.

    원격 서버에서 SSH 설정을 잘못 변경하면 재접속이 불가능해질 수 있으므로 콘솔 접근 수단을 확보한 상태에서 작업하는 것이 안전합니다.

    5. Nginx와 애플리케이션에서 Broken Pipe가 발생하는 경우

    웹서버 로그에 Broken Pipe가 반복적으로 기록된다면 SSH 설정이 아니라 HTTP 연결과 애플리케이션 응답 처리 과정을 확인해야 합니다.

    예를 들어 클라이언트가 요청을 보낸 뒤 응답을 기다리다가 브라우저를 닫거나 연결을 종료했는데, 서버가 뒤늦게 응답 데이터를 전송하려 하면 쓰기 오류가 발생할 수 있습니다.

    먼저 Nginx 오류 로그를 확인합니다.

    sudo tail -n 100 /var/log/nginx/error.log

    Access Log에서는 요청 경로와 상태 코드, 응답시간을 함께 확인하는 것이 좋습니다. 단, 응답시간 필드가 기록되는지는 실제 로그 포맷에 따라 다릅니다.

    sudo tail -n 100 /var/log/nginx/access.log

    Nginx의 499 상태 코드는 Nginx가 응답을 완료하기 전에 클라이언트가 연결을 종료했음을 나타내는 Nginx 전용 로그 코드입니다.

    하지만 Broken Pipe 오류가 발생했다고 해서 반드시 499가 함께 기록되는 것은 아닙니다. 애플리케이션이 프록시나 클라이언트로 데이터를 보내는 과정에서 발생한 별도의 소켓 오류일 수도 있습니다.

    따라서 오류가 발생한 시간대의 Nginx 로그와 애플리케이션 로그를 함께 비교해야 원인을 좁힐 수 있습니다.

    6. Python 애플리케이션의 BrokenPipeError 확인하기

    Python 서버나 스크립트에서는 다음과 같은 오류가 발생할 수 있습니다.

    BrokenPipeError: [Errno 32] Broken pipe

    예를 들어 HTTP 클라이언트가 연결을 종료한 뒤 애플리케이션이 응답을 전송하려는 상황에서 발생할 수 있습니다.

    또한 셸에서 다음과 같은 파이프라인을 실행할 때도 출력을 받는 명령어가 먼저 종료되면서 Broken Pipe가 발생할 수 있습니다.

    python3 generate_data.py | head -n 10

    head가 필요한 10줄을 읽고 종료하면 데이터를 계속 출력하려는 Python 프로세스에서 BrokenPipeError가 발생할 수 있습니다.

    이런 경우는 반드시 네트워크 장애를 의미하지 않습니다. 파이프를 읽는 프로세스가 먼저 종료된 정상적인 실행 흐름에서 발생한 부수적인 오류일 수도 있습니다.

    반면 웹 애플리케이션에서 동일한 오류가 반복된다면 클라이언트 연결 종료 시점, 응답 생성 시간, 프록시 타임아웃 및 요청 처리 구조를 함께 분석해야 합니다.

    7. TCP 연결과 네트워크 상태 확인하기

    Broken Pipe가 SSH와 웹 애플리케이션에서 동시에 발생한다면 서버의 네트워크 상태와 TCP 연결 상태도 확인할 필요가 있습니다.

    먼저 TCP 연결 목록을 확인합니다.

    ss -tan

    특정 SSH 연결을 확인하려면 다음과 같이 포트를 필터링할 수 있습니다.

    ss -tan '( sport = :22 or dport = :22 )'

    주요 TCP 상태에는 ESTAB, TIME-WAIT, CLOSE-WAIT 등이 있습니다.

    특히 CLOSE-WAIT 상태가 지속적으로 누적된다면 상대방이 연결 종료를 요청했지만 로컬 애플리케이션이 소켓을 적절하게 정리하지 못하고 있을 가능성을 확인해야 합니다.

    다만 특정 TCP 상태가 보인다는 이유만으로 Broken Pipe의 원인이 확정되는 것은 아닙니다. 오류 발생 시점의 로그와 연결 상태를 함께 비교해야 합니다.

    네트워크 경로 점검에는 다음 명령어를 사용할 수 있습니다.

    ping -c 5 server.example.com
    tracepath server.example.com

    ICMP 응답이 차단된 환경에서는 ping이나 tracepath가 실패해도 SSH나 HTTP 연결은 정상일 수 있습니다. 따라서 이 결과만으로 네트워크 장애 여부를 판단해서는 안 됩니다.

    8. 타임아웃 설정을 무조건 늘리면 해결될까?

    Broken Pipe가 반복되면 SSH KeepAlive나 Nginx의 proxy_read_timeout 값을 크게 늘리는 방법을 먼저 떠올리기 쉽습니다.

    하지만 타임아웃 설정은 실제로 어떤 연결이 먼저 종료되는지 확인한 뒤 조정해야 합니다.

    예를 들어 Nginx가 업스트림 응답을 기다리다가 타임아웃이 발생한 상황과 브라우저가 먼저 연결을 종료한 상황은 해결 방향이 다릅니다.

    응답시간이 긴 API라면 다음 항목을 함께 확인해야 합니다.

    • 애플리케이션 요청 처리 시간
    • 데이터베이스 쿼리 지연
    • 리버스 프록시와 업스트림 타임아웃
    • 로드밸런서 및 CDN 연결 제한
    • 클라이언트의 요청 취소 및 타임아웃
    • 대용량 응답 전송과 스트리밍 처리 방식

    타임아웃을 크게 늘리는 것만으로 근본 원인이 해결되는 것은 아니며, 불필요하게 오래 유지되는 연결이 늘어날 수도 있습니다.

    실전 점검 순서

    Broken Pipe 오류가 반복된다면 먼저 발생 위치를 구분하고 다음 순서로 점검하는 것이 좋습니다.

    # 1. SSH 상세 로그 확인
    ssh -vvv user@server.example.com
    
    # 2. SSH 클라이언트 KeepAlive 설정 확인
    ssh -G server.example.com | grep -Ei 'serveralive|tcpkeepalive'
    
    # 3. 서버 측 SSH 설정 확인
    sudo sshd -T | grep -Ei 'clientalive|tcpkeepalive'
    
    # 4. TCP 연결 상태 확인
    ss -tan
    
    # 5. Nginx 오류 로그 확인
    sudo tail -n 100 /var/log/nginx/error.log
    
    # 6. Nginx Access Log 확인
    sudo tail -n 100 /var/log/nginx/access.log
    
    # 7. SSH 서버 로그 확인
    sudo journalctl -u sshd -n 100

    위 명령어는 모든 서버에서 한꺼번에 실행해야 하는 절차가 아닙니다. SSH에서만 오류가 발생한다면 SSH와 네트워크를 우선 점검하고, 웹 애플리케이션에서만 발생한다면 해당 애플리케이션과 프록시 로그부터 확인해야 합니다.

    설정 변경 전에는 오류 발생 시간과 빈도, 특정 요청 또는 특정 사용자에게만 발생하는지, 유휴 상태에서 발생하는지 등을 기록해두면 변경 후 개선 여부를 비교하기 쉽습니다.

    정리

    서버에서 Broken Pipe 오류가 반복적으로 발생한다면 상대방이 데이터를 더 이상 받지 않는 상태에서 쓰기 작업이 발생했는지부터 확인해야 합니다.

    SSH에서는 유휴 연결 종료, 네트워크 경로, KeepAlive 설정을 확인하고, Nginx나 애플리케이션에서는 클라이언트 연결 종료와 응답시간, 프록시 타임아웃을 함께 분석해야 합니다.

    특히 Broken Pipe가 발생했다는 사실만으로 서버 다운이나 네트워크 장애를 단정할 수는 없습니다. 프로그램별 오류 메시지와 발생 시점의 로그를 비교해 어느 쪽에서 연결이 종료됐는지 확인하는 것이 중요합니다.

    핵심 점검 순서는 오류 발생 위치 확인 → 연결 종료 시점 분석 → TCP·로그 점검 → 필요한 설정만 변경 → 재발 여부 확인입니다.